AWS je uveo keširanje modela na SageMaker HyperPodu i izmjerio oko 60 odsto brže širenje
SageMaker HyperPod sada može da čuva težine modela na lokalnom NVMe disku čvora i da unaprijed povuče kontejnersku sliku, pa se pod koji je ranije čekao minutima pokreće za nekoliko sekundi. AWS objavljuje mjerenja na modelima od 57 do 145 gigabajta: oko 60 odsto brže širenje i keš slike koji uklanja preko dva minuta preuzimanja, odnosno 97 odsto tog vremena. Brojke su proizvođačeve i objavljene su bez opisa ogleda. Istog dana je AWS u Amazon Bedrock Managed Knowledge Base uveo i TwelveLabs Marengo 3.0 kao model za vektorske reprezentacije (embedding), pa baza znanja može da indeksira ono što se na snimku vidi, a ne samo ono što je na njemu izgovoreno.
Izvor
Amazon SageMaker HyperPod now supports model caching for faster inference autoscaling and reduced cold startsAWS What’s New — mašinsko učenje · Original objavljen 11. septembra 2026.
Hladan start je najskuplji dio posluživanja velikog modela iza automatskog širenja. Prije nego što odgovori na išta, novi pod preuzima kontejnersku sliku sa ECR-a i težine modela sa S3 ili FSx-a, a kod modela od 145 gigabajta to traje desetinama minuta. Amazon SageMaker HyperPod je sada dobio keširanje modela, koje oba preuzimanja uklanja iz vremena pokretanja. AWS ga je objavio 11. septembra 2026. Dostupno je svim korisnicima u svakom regionu u kojem HyperPod radi.
Dva keša i rezervno rješenje koje ih čini neobaveznim
Keširanje modela ima dva nezavisna dijela. Keš težina čuva težine modela na lokalnom NVMe disku čvora, pa ih pod čita s lokalnog diska umjesto da ih preuzima preko mreže sa S3 ili FSx-a. Keš slike unaprijed povlači kontejnersku sliku na čvorove klastera, pa pod pri pokretanju potpuno preskače preuzimanje sa ECR-a.
Oba keša mogu i da promaše. AWS navodi da pod koji se nađe na čvoru bez pripremljenog keša automatski prelazi na preuzimanje s izvornog mjesta, pa promašaj košta staro vrijeme pokretanja, a ne zaglavljen ili neuspio pod. Mogućnost se uključuje kroz HyperPod Inference Operator, dodavanjem odjeljka modelCacheConfig u resurs InferenceEndpointConfig ili JumpStartModel.
Šta brojke kažu, a šta izostavljaju
AWS objavljuje mjerenja na modelima od 57 do 145 gigabajta: oko 60 odsto brže širenje i smanjenje vremena preuzimanja slike za 97 odsto, čime se uklanja preko dva minuta čekanja. Navodi i da dobitak raste s veličinom modela, što slijedi iz onoga što keš zamjenjuje, jer je preuzimanje srazmjerno veličini težina, a čitanje s lokalnog diska nije.
Objava ne opisuje sam ogled. Ne imenuje modele, ne navodi tipove instanci, nema polazne brojke u sekundama i ne objašnjava kako je hladan čvor razlikovan od pripremljenog, pa je riječ o mjerenju proizvođača, a ne o nezavisnom mjerenju. Cijena se takođe ne pominje, pa se iz objave ne vidi koliko košta držanje težina na lokalnom NVMe disku.
Baza znanja u Bedrocku prestaje da zavisi od transkripcije
Amazon Bedrock Managed Knowledge Base je i ranije umio da pretražuje snimke, tako što bi zvuk i video pretvorio u tekst pa napravio vektorske reprezentacije tog teksta. Model TwelveLabs Marengo 3.0, od istog dana dostupan u toj upravljanoj bazi znanja, umjesto toga u vektorsku reprezentaciju upisuje same vizuelne prizore, govor i signale iz snimka, za šta AWS navodi da hvata značenje do kojeg sama transkripcija ne dopire.
Vektori imaju 512 dimenzija, a rezultat pretrage sadrži vrijeme početka i kraja pronađenog isječka, pa aplikacija može da skoči na taj trenutak umjesto na cijelu datoteku. Podjela snimka na isječke se podešava. AWS tačnost pretrage opisuje kao vrhunsku, ali ne navodi nijedno mjerilo, a u objavi nema ni spiska regiona ni cijena.
„Mjerenja na modelima od 57 do 145 gigabajta pokazuju oko 60 odsto brže širenje“
Izvori
Povezano
Microsoftov ThinkingBox pokazuje da nijedan model ne rješava pola zadataka 20 puta zaredom
Microsoftov tim Copilot Studio objavio je 3. oktobra 2026. na blogu platforme Hugging Face rezultate testa performansi ThinkingBox. Test svaki od 507 poslovnih tokova rada pokreće 20 puta po modelu i ocjenjuje stanje baze podataka koje agent ostavi, a ne njegovu završnu poruku. Microsoft navodi da Claude Opus 5.5 ima najbolji rezultat u pojedinačnom pokušaju, 67,16 odsto, ali da u svih 20 pokušaja rješava samo 241 zadatak. Prema autorima, približno četiri od pet neuspjeha potiču od rukovanja alatima, a ne od rezonovanja.
Microsoft, Hugging Faceprovjereno
Ai2 je objavio AstaBrief, model s otvorenim težinama koji piše izvještaje s citatima
Ai2 je 2. oktobra 2026. objavio težine i podatke za obučavanje modela AstaBrief. Model od istraživačkog pitanja i pronađenih odlomaka iz literature pravi izvještaj s citatima. Prema mjerenju Ai2, režim Fast na platformi Asta u prosjeku napravi izvještaj za 51,1 sekundu, a režim koji pokreće Claude za 178,5 sekundi. Licenca je Apache 2.0, a Ai2 navodi da je evaluacija rađena prije pojave sadašnjih vodećih modela.
Ai2provjereno
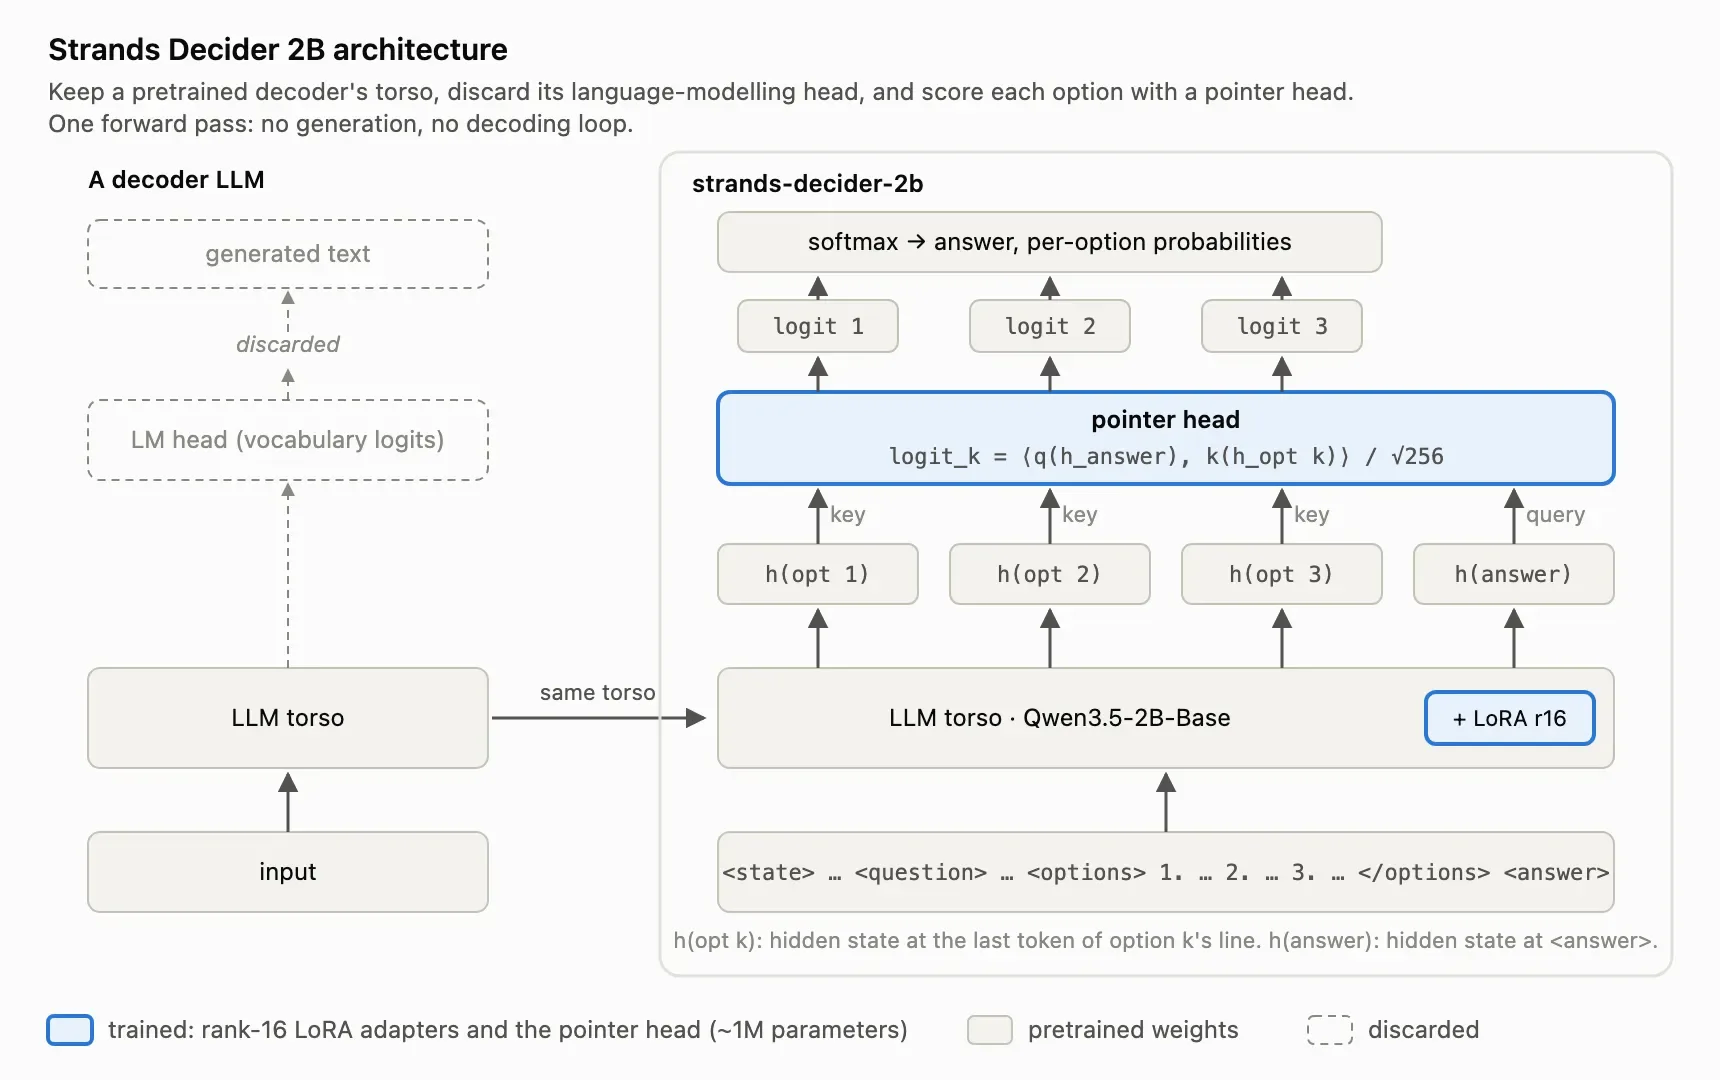
Amazonov Strands Labs objavio je Strands Decider, otvoreni model odlučivanja koji radi lokalno
Strands Labs, eksperimentalni dio projekta Strands Agents, objavio je 1. oktobra 2026. model odlučivanja Strands Decider. Model ne piše tekst: bira jednu od ponuđenih opcija, odgovara sa da ili ne ili daje ocjenu na skali, a uz svaki odgovor navodi stepen pouzdanosti. Prema mjerenju tima, medijana trajanja jedne odluke na Nvidijinoj grafičkoj kartici RTX 3090 iznosi 115 milisekundi. Kôd, težine, podaci za obuku i skripte objavljeni su pod licencom Apache-2.0.
Strands Agentsprovjereno