Microsoftov ThinkingBox pokazuje da nijedan model ne rješava pola zadataka 20 puta zaredom
Microsoftov tim Copilot Studio objavio je 3. oktobra 2026. na blogu platforme Hugging Face rezultate testa performansi ThinkingBox. Test svaki od 507 poslovnih tokova rada pokreće 20 puta po modelu i ocjenjuje stanje baze podataka koje agent ostavi, a ne njegovu završnu poruku. Microsoft navodi da Claude Opus 5.5 ima najbolji rezultat u pojedinačnom pokušaju, 67,16 odsto, ali da u svih 20 pokušaja rješava samo 241 zadatak. Prema autorima, približno četiri od pet neuspjeha potiču od rukovanja alatima, a ne od rezonovanja.
Izvor
The Agent Said It Was Done. The Database Disagreed.Hugging Face Blog · Original objavljen 3. oktobra 2026.
ThinkingBox je izolovano okruženje (sandbox) za agente, a ThinkingBox-Bench je test performansi koji se u njemu izvršava. Microsoft i Hugging Face objavili su rezultate i uputstvo za pokretanje 3. oktobra 2026. Svaki od 507 zadataka počinje od čistog stanja pozadinskog sistema, a izvršne provjere porede krajnje zapise sa zadatim krajnjim stanjem. Autori su ispitali 18 modela, 10 vlasničkih i osam s otvorenim težinama, i za svaki su objavili tri broja.
Tri broja za svaki model
Prvi broj, pass@1, pokazuje udio uspješnih među svim pokušajima. Drugi, pass@20, pokazuje udio zadataka koje je model riješio bar jednom u 20 pokušaja. Treći je broj zadataka koje je model riješio u svih 20 zabilježenih pokušaja.
Microsoft navodi da po mjeri pass@1 Claude Opus 5.5 ima 67,16 odsto, Claude Opus 5 ima 66,50 odsto, a GPT-5.4 ima 65,36 odsto. Najbolji model s otvorenim težinama je Kimi-K3, sa 57,37 odsto. Rezultat znatno zavisi od oblasti: prosjek ispitanih modela u zadacima iz maloprodaje je 59,52 odsto, a u zadacima iz auto-osiguranja 33,83 odsto.
Šta ostane poslije 20 ponavljanja
Prema Microsoftovim podacima, Claude Opus 5.5 i Claude Opus 5 u svakom pokušaju rješavaju po 241 zadatak od 507, što je 47,53 odsto. GPT-6 Astra tako rješava 231 zadatak. GPT-5.4 rješava 128 zadataka, a GPT-5.6 Sol 82 zadatka.
Najveća razlika zabilježena je kod modela Kimi-K3. Autori navode da taj model bar jednom rješava 476 od 507 zadataka, najviše u cijelom ispitivanju, ali u svih 20 pokušaja samo 68 zadataka. Claude Opus 5 bar jednom rješava manje zadataka, 79,09 odsto, ali znatno više njih rješava svaki put.
Koliko košta pouzdano riješen zadatak
Autori su zabilježenu potrošnju tokena svakog modela obračunali po cjenovnicima bez popusta na servisu OpenRouter, prema stanju od 20. septembra 2026. Dobijeni iznos opisuju kao uporedni pokazatelj efikasnosti, a ne kao račun.
Po trošku jednog uspješnog pokušaja Microsoft na prvo mjesto stavlja GPT-5.6 Sol, sa 0,127 dolara. Slijede GPT-5.4 sa 0,131 dolara i Claude Opus 5.5 sa 0,276 dolara. Claude Opus 5 košta 0,475 dolara po uspješnom pokušaju, uz slabiji rezultat od modela Opus 5.5.
Redoslijed se mijenja kad se trošak svih 20 izvršavanja podijeli brojem zadataka riješenih svaki put. Po toj mjeri autori navode 6,80 dolara po pouzdano riješenom zadatku za GPT-5.4, 7,45 dolara za GPT-6 Astra i 7,80 dolara za Claude Opus 5.5. Za GPT-5.6 Sol navode 9,76 dolara, a za Claude Opus 5 13,30 dolara. Za Kimi-K3 taj trošak iznosi 20,68 dolara.
Gdje agenti griješe
U podskupu od 121.680 valjanih pokušaja na 12 modela izvršne provjere nije prošlo 79.853 pokušaja. Microsoft navodi da se 67,24 odsto tih neuspjeha ipak uredno završilo, pozvalo alat koji mijenja stanje i nije prijavilo završnu grešku alata.
Autori svakom neuspjelom izvršavanju dodjeljuju jednu dijagnostičku oznaku. Upotreba alata čini 79,9 odsto neuspjeha, pogrešne izmjene stanja 10,3 odsto, nepotpuno rješavanje korisnikovog zahtjeva 7,0 odsto, a izvršavanja bez ijedne izmjene stanja 2,9 odsto. Microsoft obrazac opisuje ovako: agent započne tok rada, a zatim se ne oporavi od greške alata, neispunjenog preduslova ili prazne pretrage.
Microsoft preporučuje četiri mjere. Krajnje stanje treba provjeriti prije potvrde izmjene, a greške alata razvrstati kako bi se ponavljali samo pokušaji koji se mogu oporaviti. Skup alata treba smanjiti, a za izmjene koje se teško poništavaju tražiti ljudsko odobrenje. Autori navode da učinak nijedne od tih mjera nisu izmjerili na ovom testu.
Kako se test pokreće
Okvir za izvršavanje i skup podataka dostupni su na platformi Hugging Face, a test se pokreće preko interfejsa OpenEnv. Autori su postavku ispitali na Linuxu i u okruženju WSL, uz Python 3.11 ili noviji, alat uv i Docker. Potrebne su i krajnje tačke modela za agenta, simuliranog korisnika i ocjenjivača, a jedna krajnja tačka može obavljati sve tri uloge.
Kod okvira ThinkingBox objavljen je pod licencom MIT, podaci testa pod licencom CDLA-Permissive-2.0, a okruženje OpenEnv pod licencom BSD-3-Clause. Svi zadaci su sintetičke rekonstrukcije, a 477 od 507 zadataka ocjenjuje se samo po stanju. Rezultate su objavili autori testa, a u objavi se ne navodi nezavisno ponavljanje mjerenja. Rad koji opisuje test objavljen je na arXivu i nije prošao recenziju.
„Putanja izvršavanja je tvrdnja. Stanje baze podataka je dokaz.“
Izvori
Povezano
OpenAI uvodi vodeni žig u tekst ChatGPT-a i Codexa u EU, a u API-ju se uključuje po izboru
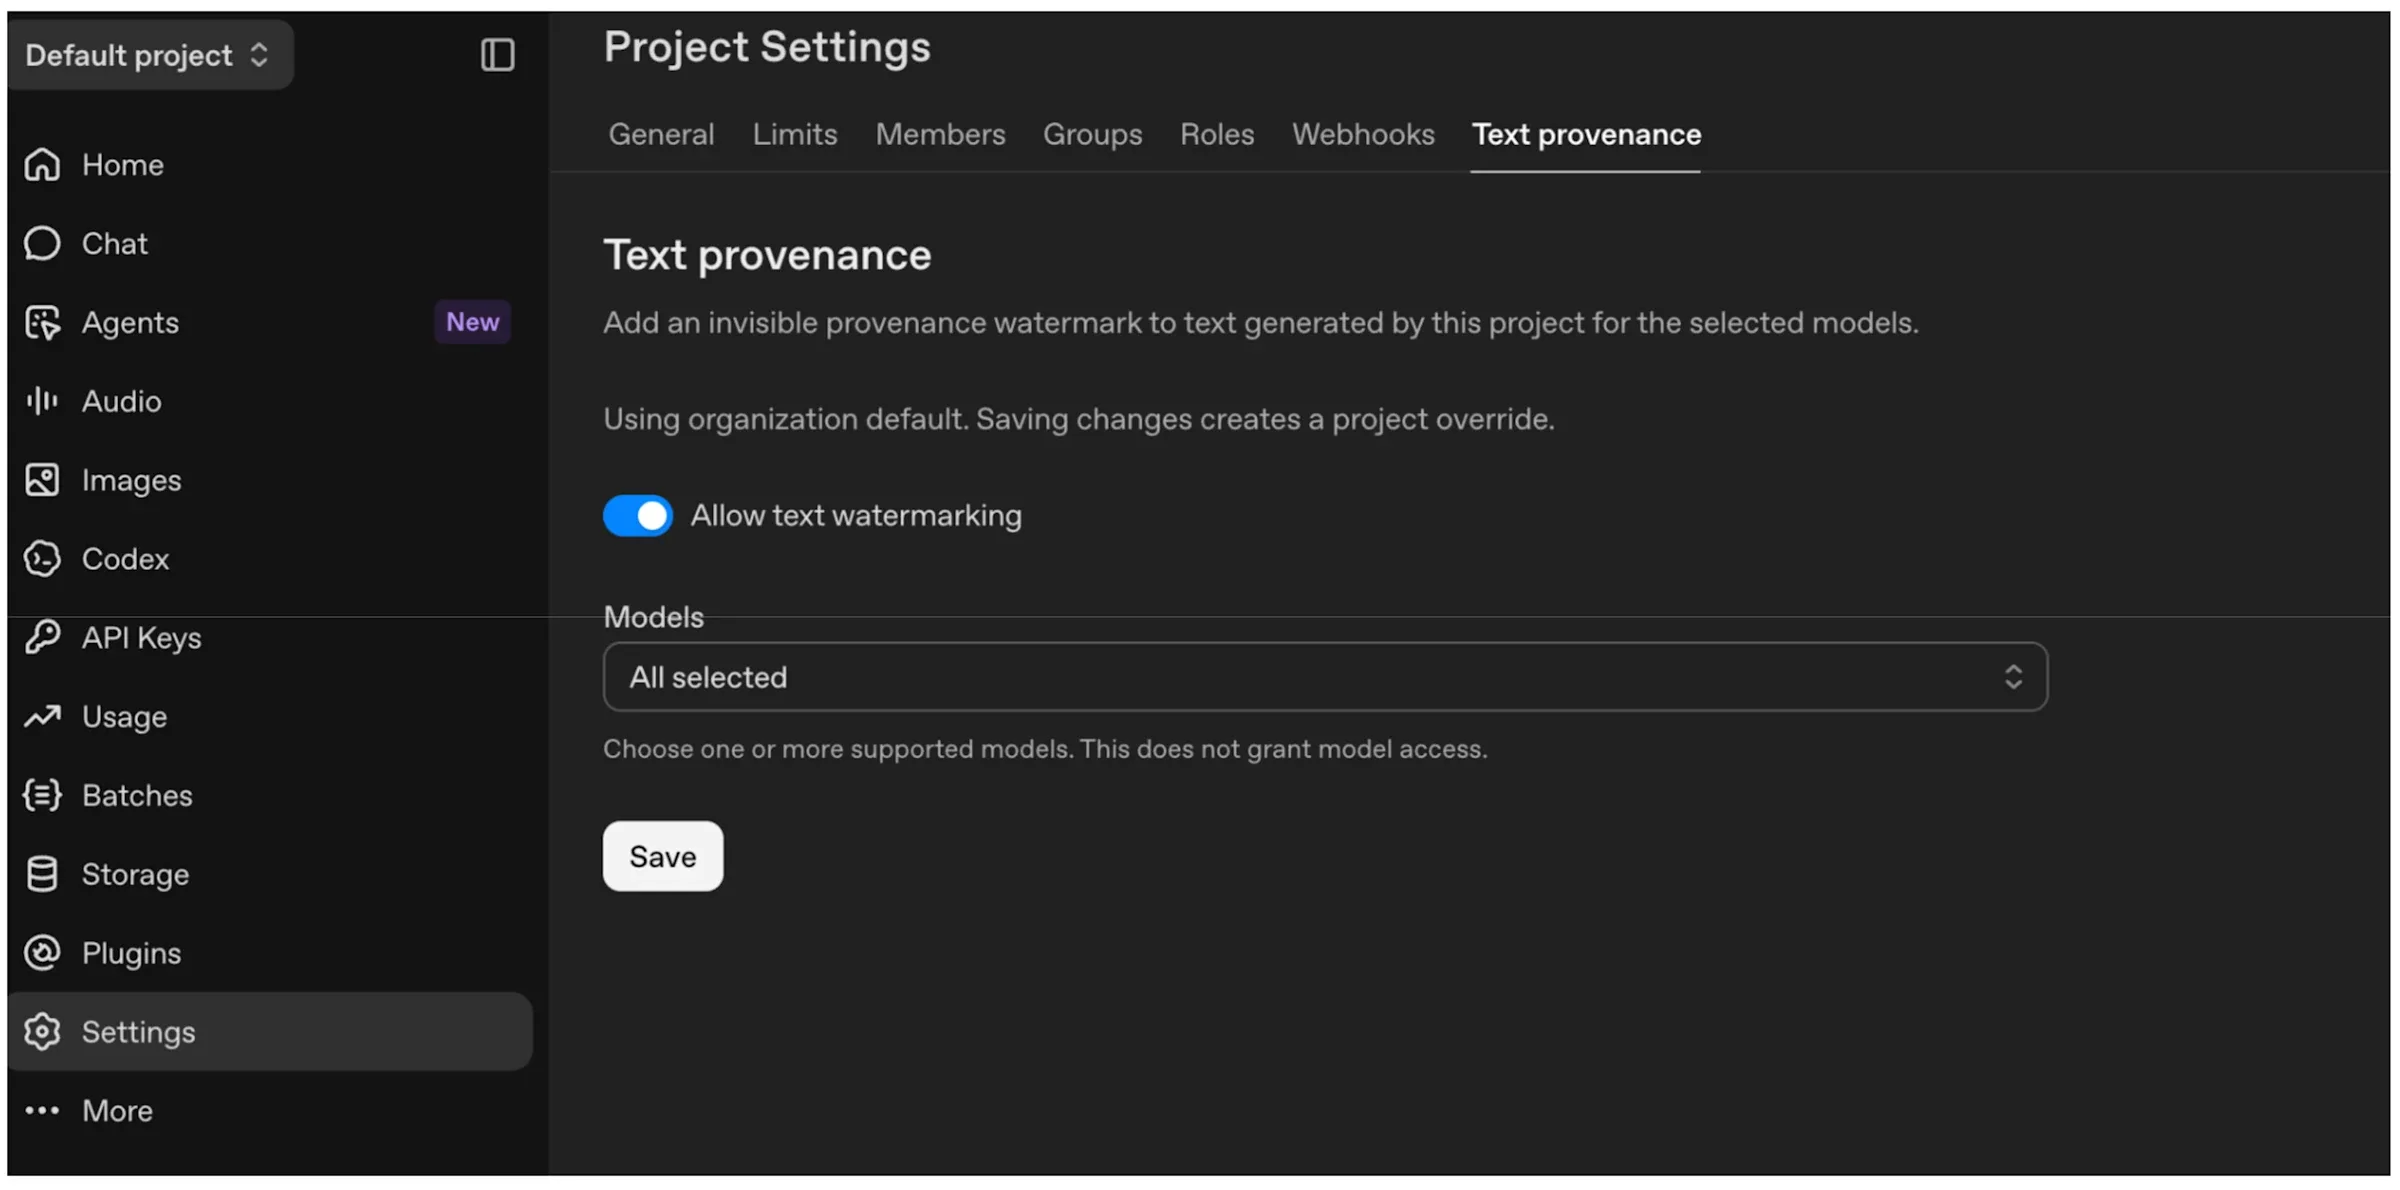
OpenAI je 5. oktobra 2026. objavio kako će tekst koji generišu njegovi modeli označavati vodenim žigom, radi usklađivanja s Aktom Evropske unije o vještačkoj inteligenciji (EU AI Act). Tekst iz ChatGPT-a i Codexa u Evropskoj uniji dobiće u narednim sedmicama nevidljiv vodeni žig pod nazivom textGrain. Korisnici API-ja u cijelom svijetu mogu od istog dana da ga uključe za odabrane modele, a podrazumijevano je isključen. Detektor nije javan: pristup dobijaju samo odobreni istraživači i stručne organizacije.
OpenAIprovjereno
Šest komercijalnih rutera modela u novom radu nije nadmašilo nasumičan izbor između dva modela
Rad predat na arXiv 2. oktobra 2026. ispitao je šest komercijalnih rutera velikih jezičkih modela u 14 podešavanja. Autori navode da nijedno podešavanje nije nadmašilo ruter koji uz isti trošak nasumično bira između modela Gemini 3.7 Flash i Opus 5, a jedno je zaostalo 10,5 procentnih poena. Autori, zaposleni u kompaniji Fastino Labs, razliku objašnjavaju načinom na koji se ruteri ocjenjuju i prevelikim skupovima modela. Rad nije prošao recenziju.
arXiv, Fastino Labsprovjereno
Ai2 je objavio AstaBrief, model s otvorenim težinama koji piše izvještaje s citatima
Ai2 je 2. oktobra 2026. objavio težine i podatke za obučavanje modela AstaBrief. Model od istraživačkog pitanja i pronađenih odlomaka iz literature pravi izvještaj s citatima. Prema mjerenju Ai2, režim Fast na platformi Asta u prosjeku napravi izvještaj za 51,1 sekundu, a režim koji pokreće Claude za 178,5 sekundi. Licenca je Apache 2.0, a Ai2 navodi da je evaluacija rađena prije pojave sadašnjih vodećih modela.
Ai2provjereno