Šest komercijalnih rutera modela u novom radu nije nadmašilo nasumičan izbor između dva modela
Rad predat na arXiv 2. oktobra 2026. ispitao je šest komercijalnih rutera velikih jezičkih modela u 14 podešavanja. Autori navode da nijedno podešavanje nije nadmašilo ruter koji uz isti trošak nasumično bira između modela Gemini 3.7 Flash i Opus 5, a jedno je zaostalo 10,5 procentnih poena. Autori, zaposleni u kompaniji Fastino Labs, razliku objašnjavaju načinom na koji se ruteri ocjenjuju i prevelikim skupovima modela. Rad nije prošao recenziju.
Ruter modela (LLM router) je servis koji svaki zahtjev prosljeđuje jednom od više modela, kako bi jeftin model obradio ono što može, a skup model ostalo. Rad pod naslovom Dynamic LLM Routers are Often Misguided provjerava da li komercijalni proizvodi taj cilj ostvaruju. Šest autora je svaki proizvod uporedilo s najjednostavnijim mogućim referentnim ruterom i navodi da je referentni ruter bio najmanje jednako tačan.
Kako je ispitivanje sprovedeno
Autori su ispitali rutere tri opšte platforme, OpenRouter, Microsoft Azure i vLLM, i tri firme specijalizovane za usmjeravanje zahtjeva: Not Diamond, Nadir i Orca. Proizvodi su ispitani u ukupno 14 podešavanja, na primjer u režimu okrenutom trošku i u režimu okrenutom kvalitetu istog proizvoda.
Skup za ocjenjivanje sadrži 800 zahtjeva iz 17 testova performansi, raspoređenih u osam kategorija sa po 100 zahtjeva. Kategorije su programiranje, praćenje uputstava, znanje, matematika, odgovaranje na pitanja, kancelarijski poslovi, upotreba alata i test Humanity’s Last Exam. Za svaki zahtjev autori su zabilježili koji je model ruter izabrao. Odgovor tog modela su zatim sami generisali i ocijenili, uz podrazumijevana podešavanja i cijene servisa OpenRouter, kako bi svi ruteri bili mjereni na isti način.
Referentni ruter ne uzima u obzir sadržaj zahtjeva. On s unaprijed određenom vjerovatnoćom bira Gemini 3.7 Flash, a u ostalim slučajevima Anthropicov Opus 5, u podešavanju koje rad označava kao Opus 5 (high). Vjerovatnoća je podešena tako da trošak referentnog rutera bude jednak trošku rutera s kojim se poredi.
Šta pokazuje poređenje
Prema navodima autora, nijedno od 14 podešavanja nije bilo tačnije od nasumičnog referentnog rutera uz isti trošak. Orca je u prilagodljivom režimu zaostala 10,5 procentnih poena. Not Diamond u režimu okrenutom trošku i jedno podešavanje OpenRouterovog rutera auto-beta zaostali su po 8,8 poena, a Azure u uravnoteženom režimu 8,4 poena.
Najmanju razliku ima vLLM Semantic Router: 1,0 poen, uz interval pouzdanosti od 1,8 poena u oba smjera. To je jedini proizvod čiji rezultat nije značajno ispod referentnog rutera, a autori napominju da je podešen na njihovim podacima za obučavanje.
Autori su poređenje ponovili tako što su referentnom ruteru ostavili samo modele dostupne svakom pojedinom ruteru. Navode da ga ni tada nijedan komercijalni ruter nije nadmašio, pa rezultat ne proizlazi iz toga što referentni ruter koristi novije modele.
Četiri obrasca iza razlike
Rad razliku pripisuje četirima obrascima i navodi da svaki ispitani ruter pokazuje nekoliko njih.
- Neosjetljivost na težinu (difficulty blindness): izbor modela je u najboljem slučaju slabo povezan s težinom zahtjeva, pa najteži zahtjevi stižu do jačeg modela rjeđe nego što bi trebalo.
- Obrnut odnos prema dužini (length reversal): dio rutera troši manje na zahtjeve s dužim odgovorima, iako su takvi zahtjevi po pravilu teži.
- Usmjeravanje po izvoru (semantic matching): ruteri većinu zahtjeva iz istog izvora šalju jednom modelu, bez obzira na težinu pojedinačnog zahtjeva.
- Loše sastavljen skup modela (roster suboptimality): skupovi sadrže mnogo modela koji nisu na granici najboljeg odnosa troška i tačnosti, ili takve modele izostavljaju.
Zašto su dva modela dovoljna
Prema autorima, prva tri obrasca nagrađuje uobičajeni način ocjenjivanja rutera. Testovi za rutere porede trošak i tačnost. Po toj mjeri se prosljeđivanje skupljem modelu najviše isplati kad on ima znatno veće izglede na uspjeh i kad je odgovor kratak. Na najtežim zahtjevima oba modela najčešće griješe, pa prosljeđivanje donosi malo.
O skupovima modela rad navodi da Gemini 3.7 Flash u skupu od 26 ispitanih modela zaostaje za modelom Opus 5 (high) 1,6 procentnih poena, uz 96 odsto nižu cijenu. Čak i ruter koji bi tačno znao težinu svakog zahtjeva dobio bi najviše 1 procentni poen od skupa većeg od dva modela.
Autori su napravili i sopstveni ruter s dva modela, koji izbjegava sva četiri obrasca. Njegova tačnost je po uobičajenoj metodologiji pri svakom budžetu ostala u granicama statističkog šuma u odnosu na nasumično usmjeravanje. Njihov zaključak je da gotovo svu tačnost određuje skup modela, a ne ruter.
Šta rad ne pokazuje
Ograničenja navode sami autori. Ispitani su samo zahtjevi bez nastavka razgovora, a promjena modela usred razgovora ima sopstvenu cijenu zbog keširanja. Svi zahtjevi su na engleskom jeziku i potiču iz testova performansi, koji ne moraju da liče na stvarni saobraćaj, a svaki odgovor je generisan jednom.
Rad nije recenziran, a autori navode da je predat na ocjenu za konferenciju NAACL. Rad mjeri tačnost uz isti trošak i nijedan drugi razlog za upotrebu rutera, a rezultati su mjerenje samih autora.
„Gotovo svu tačnost određuje skup modela, a ne ruter.“
Izvori
Povezano
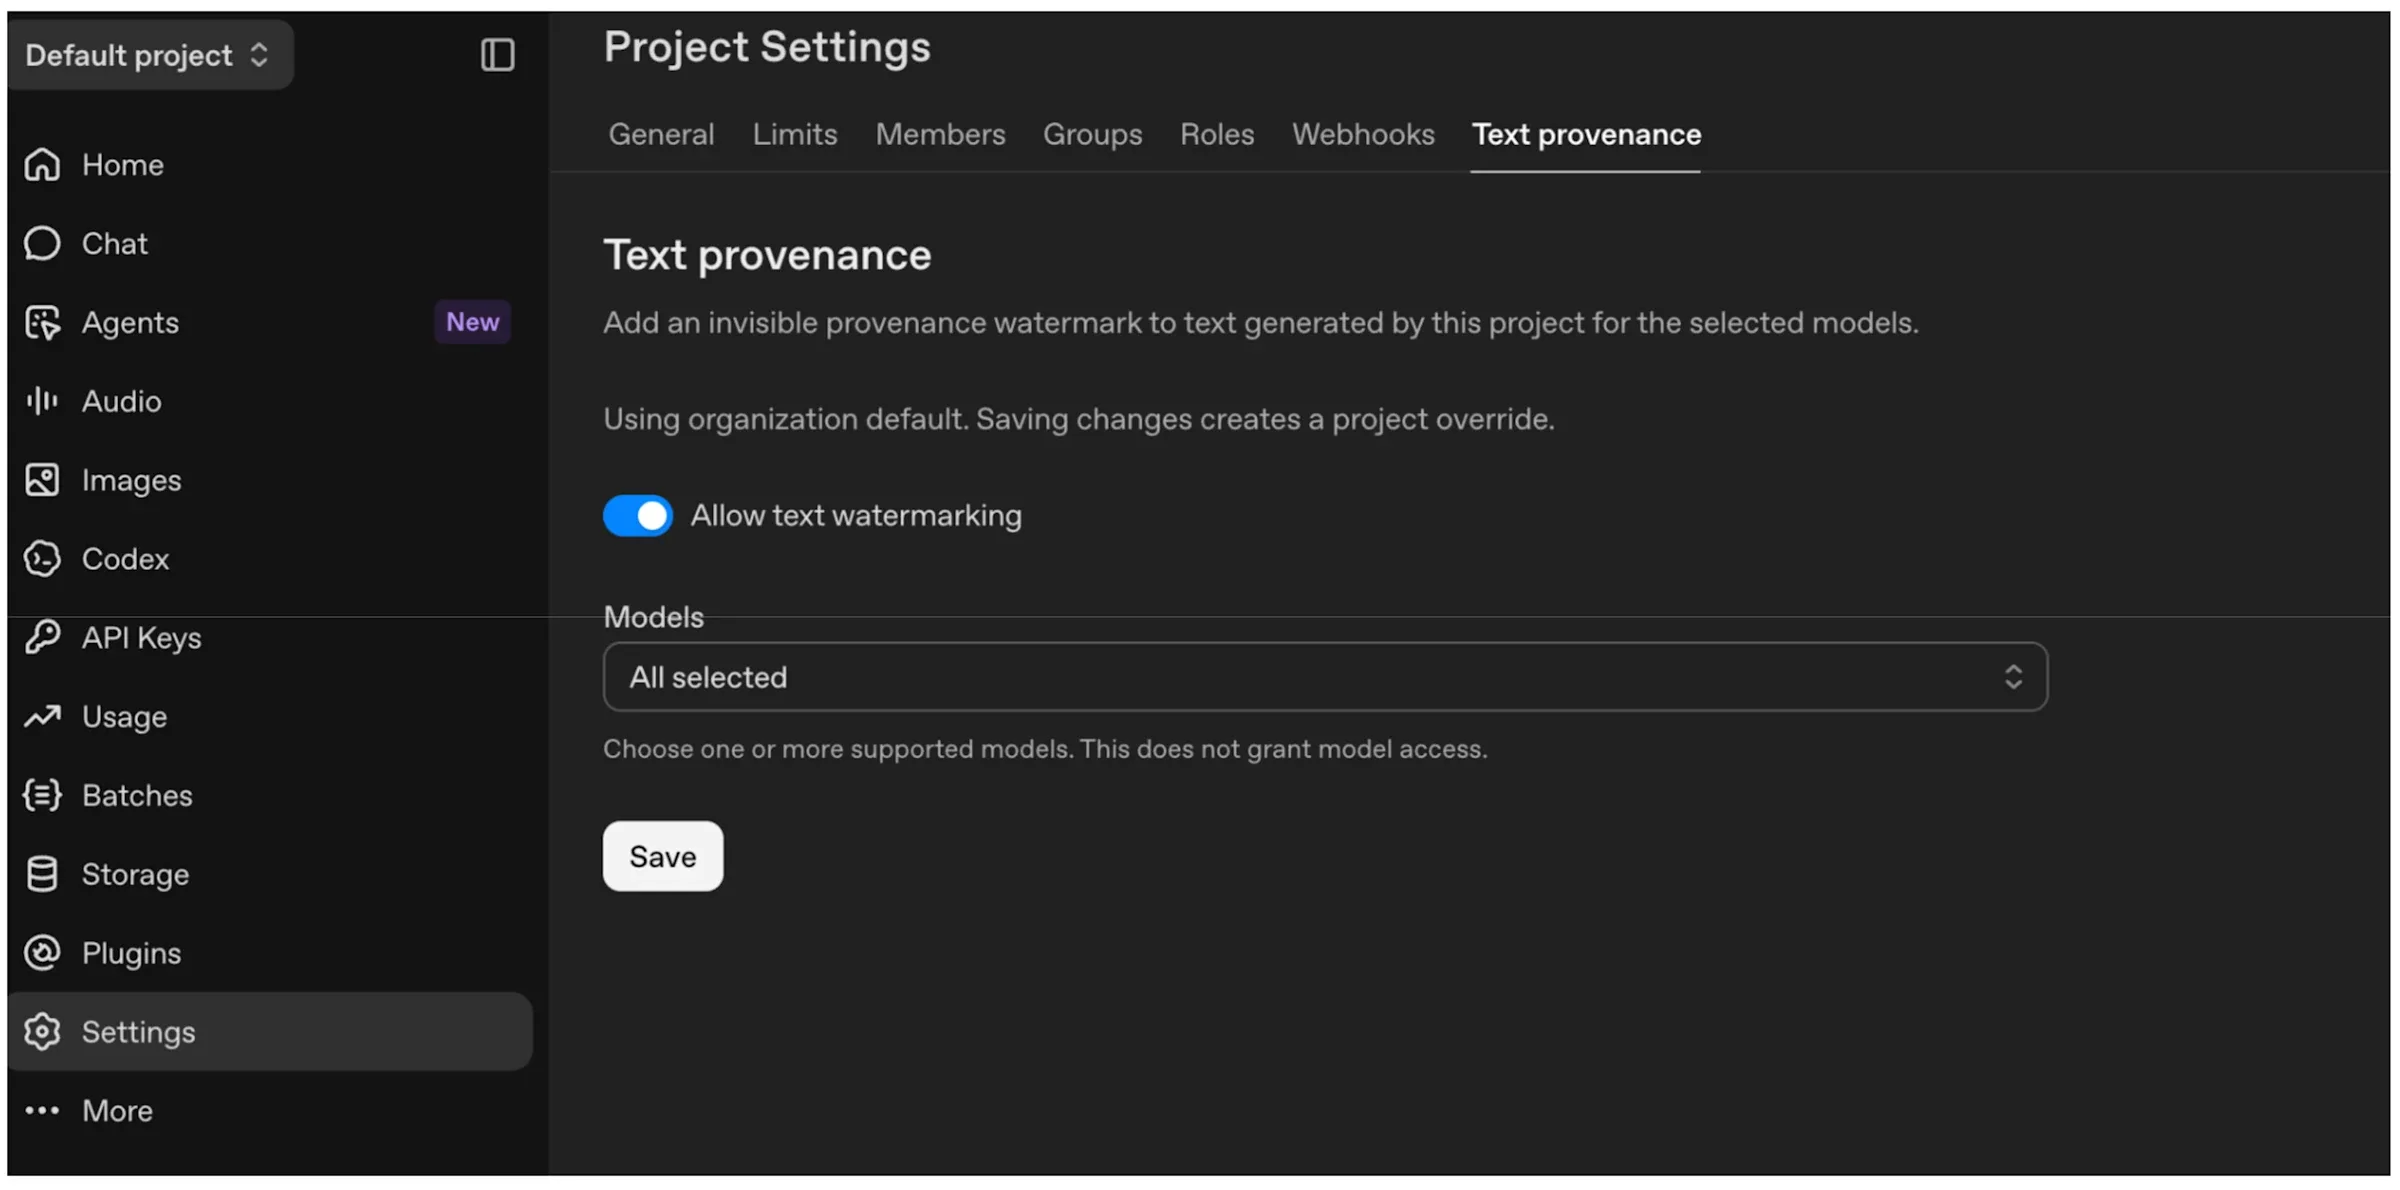
OpenAI uvodi vodeni žig u tekst ChatGPT-a i Codexa u EU, a u API-ju se uključuje po izboru
OpenAI je 5. oktobra 2026. objavio kako će tekst koji generišu njegovi modeli označavati vodenim žigom, radi usklađivanja s Aktom Evropske unije o vještačkoj inteligenciji (EU AI Act). Tekst iz ChatGPT-a i Codexa u Evropskoj uniji dobiće u narednim sedmicama nevidljiv vodeni žig pod nazivom textGrain. Korisnici API-ja u cijelom svijetu mogu od istog dana da ga uključe za odabrane modele, a podrazumijevano je isključen. Detektor nije javan: pristup dobijaju samo odobreni istraživači i stručne organizacije.
OpenAIprovjereno
Microsoftov ThinkingBox pokazuje da nijedan model ne rješava pola zadataka 20 puta zaredom
Microsoftov tim Copilot Studio objavio je 3. oktobra 2026. na blogu platforme Hugging Face rezultate testa performansi ThinkingBox. Test svaki od 507 poslovnih tokova rada pokreće 20 puta po modelu i ocjenjuje stanje baze podataka koje agent ostavi, a ne njegovu završnu poruku. Microsoft navodi da Claude Opus 5.5 ima najbolji rezultat u pojedinačnom pokušaju, 67,16 odsto, ali da u svih 20 pokušaja rješava samo 241 zadatak. Prema autorima, približno četiri od pet neuspjeha potiču od rukovanja alatima, a ne od rezonovanja.
Microsoft, Hugging Faceprovjereno
Ai2 je objavio AstaBrief, model s otvorenim težinama koji piše izvještaje s citatima
Ai2 je 2. oktobra 2026. objavio težine i podatke za obučavanje modela AstaBrief. Model od istraživačkog pitanja i pronađenih odlomaka iz literature pravi izvještaj s citatima. Prema mjerenju Ai2, režim Fast na platformi Asta u prosjeku napravi izvještaj za 51,1 sekundu, a režim koji pokreće Claude za 178,5 sekundi. Licenca je Apache 2.0, a Ai2 navodi da je evaluacija rađena prije pojave sadašnjih vodećih modela.
Ai2provjereno