Preskoči na sadržaj

Oznake

Lokalno izvođenje

19 stavki
LLAMA.CPP B115567,63 GBBonsai 2 bez posebne verzije
Mašine i lokalni modelisrednji signal

llama.cpp sada pokreće ternarni model Bonsai 2 bez posebne verzije kompanije PrismML

Izdanje b11556 dodaje rotaciju težina koja je modelu Bonsai 2 nedostajala u zvaničnom llama.cpp-u. Datoteka Q2_0 od 7,63 GB tamo sada daje ispravan izlaz, a manja pakovanja PQ2_0 i PTQ1_0 i dalje traže verziju same kompanije.

llama.cppprovjereno
Ilustracija procesorskog čipa na tamnoplavoj podlozi, obavijenog svijetlim plavim i narandžastim tokovima podataka, sa sočivom kamere i lebdećim panelima s grafikonima oko njega.
Mašine i lokalni modelisrednji signal

Google je objavio ML Drift kao otvoreni kod, a TFLite GPU delegat više neće dobijati nove mogućnosti

Googleov tim AI Edge objavio je 8. oktobra 2026. pokretač ML Drift pod licencom Apache 2.0. To je dio LiteRT-a koji izvodi modele na grafičkom procesoru samog uređaja, a može se koristiti i kao zasebna biblioteka. Stariji TFLite GPU delegat od sada ne dobija nove mogućnosti, pa aplikacije koje ga koriste čeka prelazak.

Google Developers Blogprovjereno

Natpis EmbeddingGemma 2 u bijeloj i plavoj boji na tamnoplavoj podlozi od nagnutih staklenih ploča.
Modelisrednji signal

EmbeddingGemma 2 ugrađuje tekst, slike, zvuk i video u jedan otvoren model od 740 miliona parametara

Google DeepMind je 6. oktobra 2026. objavio EmbeddingGemma 2 pod licencom Apache 2.0. Model od 740 miliona parametara preslikava tekst, kod, slike, video i zvuk u jedan prostor vektora i napravljen je da radi na telefonu. Zadržava višejezični kvalitet prve verzije na tekstu, podiže rezultat na MTEB Code za skoro deset bodova, a već ga podržavaju llama.cpp, Ollama, MLX, vLLM i transformers.js.

Google DeepMindprovjereno

Mašine i lokalni modelisrednji signal

llama.cpp 0.6.0 podržava GLM-5.3-Flash, a server dobija API za modele za odlučivanje

Projekat llama.cpp objavio je 5. oktobra 2026. verziju 0.6.0. Izdanje dodaje podršku za GLM-5.3-Flash, model za tekst i sliku sa 320 milijardi parametara, i novu krajnju tačku servera za modele za odlučivanje (decision models). Dvije izmjene u spekulativnom dekodiranju objavljene su uz mjerenja autora, jedno na računaru DGX Spark kompanije Nvidia i jedno na Appleovim grafičkim procesorima. Izmijenjeni su i C API i verzija formata sačuvanih sesija, pa programe koji koriste biblioteku treba provjeriti prije nadogradnje.

llama.cppprovjereno

Modelisrednji signal

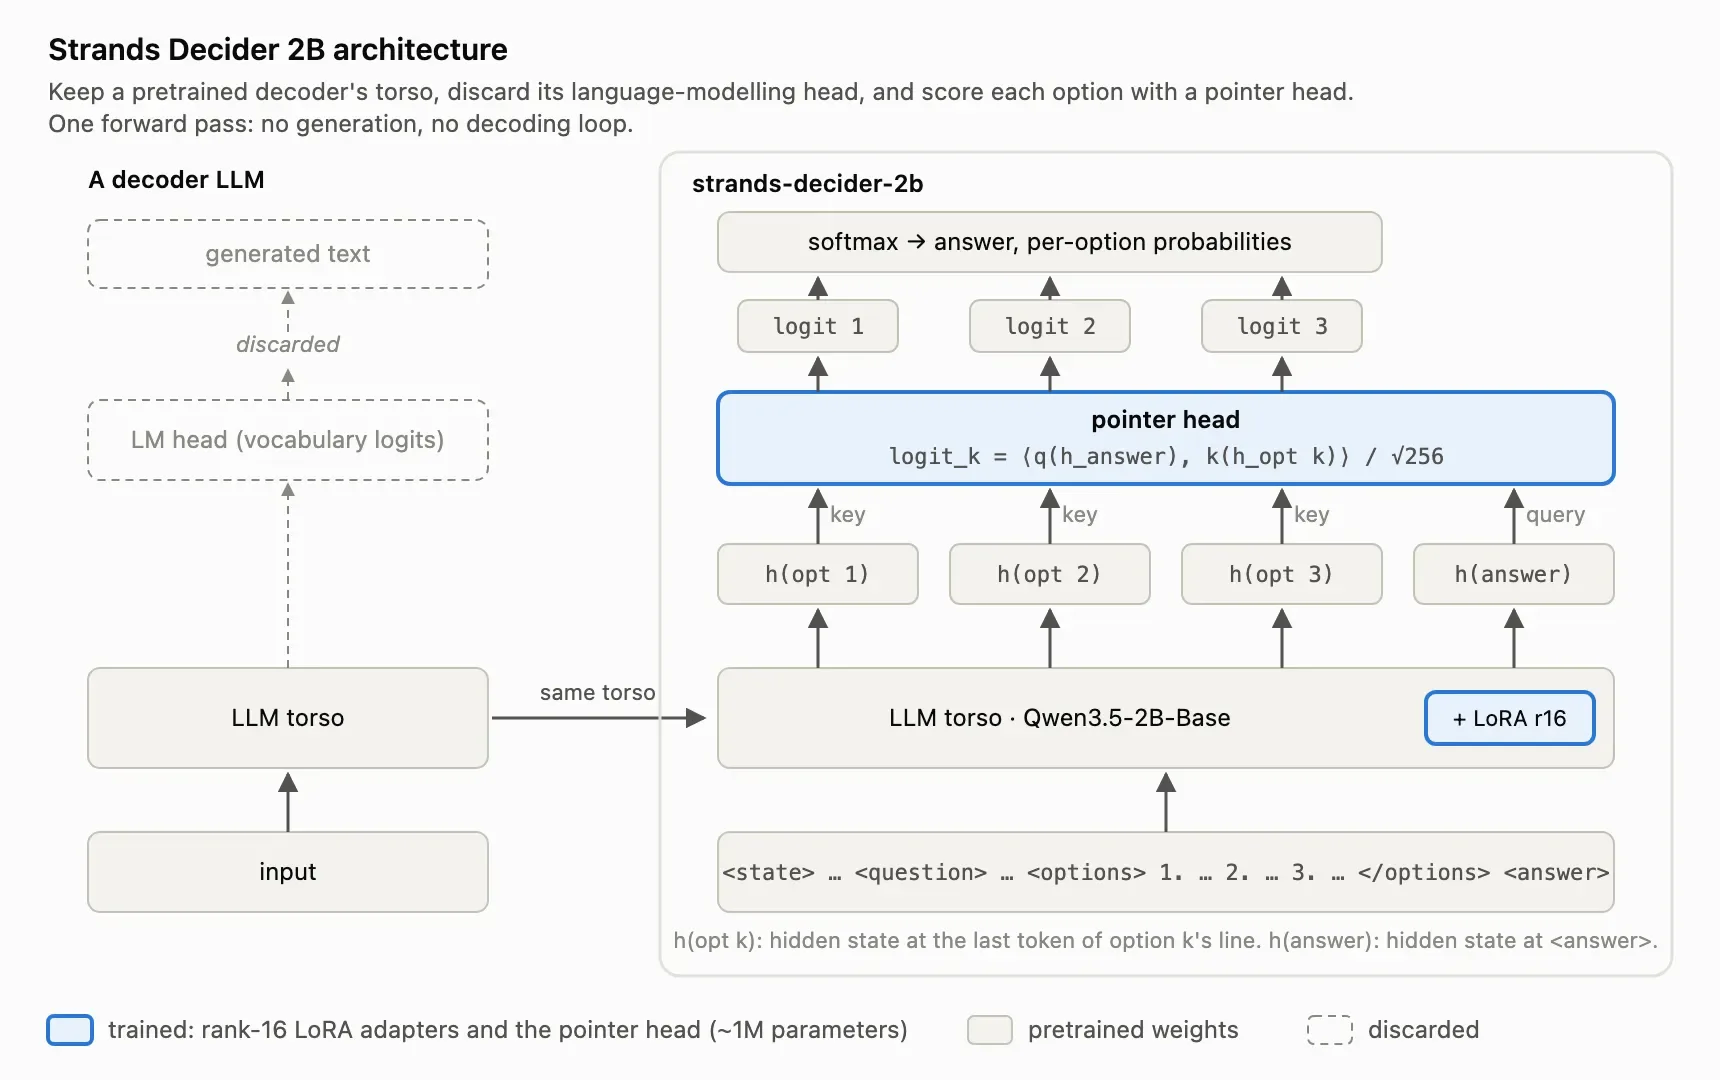
Amazonov Strands Labs objavio je Strands Decider, otvoreni model odlučivanja koji radi lokalno

Strands Labs, eksperimentalni dio projekta Strands Agents, objavio je 1. oktobra 2026. model odlučivanja Strands Decider. Model ne piše tekst: bira jednu od ponuđenih opcija, odgovara sa da ili ne ili daje ocjenu na skali, a uz svaki odgovor navodi stepen pouzdanosti. Prema mjerenju tima, medijana trajanja jedne odluke na Nvidijinoj grafičkoj kartici RTX 3090 iznosi 115 milisekundi. Kôd, težine, podaci za obuku i skripte objavljeni su pod licencom Apache-2.0.

Strands Agentsprovjereno

Mašine i lokalni modelisrednji signal

llama.cpp 0.5.0 podržava arhitekturu HRM-Text, a njegov server može da prima veze na više adresa

Projekat llama.cpp je 23. septembra 2026. objavio verziju 0.5.0. Izdanje dodaje podršku za HRM-Text, arhitekturu na kojoj je građen DFM Mimir, model od milijardu parametara, i konverziju modela MiMo-V2.6. Server sada može istovremeno da prima veze na više adresa, a u režimu rutera više ne prosljeđuje datoteku s API ključevima procesima koje pokreće.

llama.cppprovjereno

Mašine i lokalni modelisrednji signal

Transformers sada pokreće llama.cpp kvantizacije na Apple Siliconu

Kontrolna tačka u obliku GGUF predaje se funkciji from_pretrained i pokreće sa težinama koje ostaju spakovane, uz ggml kernele za Metal iz biblioteke kernels. Cilj je jedan razgovor u živo na Macu s Apple Silicon čipom, a taj put pokriva arhitekture Qwen3.5, i u obliku sa svim aktivnim parametrima i u obliku mješavine eksperata, te odgovarajuće kontrolne tačke modela Qwen3.8. Hugging Face navodi da je rezultat blizu llama.cpp-a na tri mjerene kontrolne tačke, uz napomenu da dva mjerenja nisu rađena pod istovjetnim uslovima. Kao motor za efikasno lokalno izvođenje i dalje preporučuje llama.cpp.

Hugging Faceprovjereno

Mašine i lokalni modelisrednji signal

Izdanje b11077 alata llama.cpp više ne prosljeđuje datoteku s ključevima podređenim serverima

Izdanje b11077 objavljeno je 21. septembra 2026. i ispravlja kvar u prijavi u režimu rutera alata llama.cpp. Kad je server pokrenut i s ključem u komandnoj liniji i s datotekom ključeva, podređene instance su provjeravale samo ključeve iz datoteke, pa je klijent s ključem iz komandne linije mogao da dobije spisak modela, a na svaki razgovor s modelom dobijao je odgovor 401. Ista izmjena zaustavlja i to da putanja do datoteke ključeva uopšte stigne do podređenog procesa. Riječ je o jednoj liniji u jednoj datoteci, a razlika je između postavke koja radi i one koja izgleda zdravo dok odbija posao.

llama.cppprovjereno

Mašine i lokalni modelisrednji signal

Google je otvorio pretprodaju Googlebooka od 899 dolara, s Linux terminalom nad sertifikovanim hipervizorom

Google je 21. septembra 2026. otvorio pretprodaju prenosnih računara Googlebook. Cijene počinju od 899 dolara, a isporuka kreće 4. oktobra 2026. Računari rade na sistemu građenom na Androidu, sa stonim temeljima iz ChromeOS-a, na procesorima kompanija Intel i Qualcomm uz namjenske neuronske procesore preko 45 TOPS. Za onoga ko piše kod najvažniji dio nije spisak pomoćnih mogućnosti nego hipervizor pKVM sa bezbjednosnim sertifikatom nivoa 5, koji pokreće izolovano Linux okruženje s punim pristupom terminalu. Nijedna od dvije objave ne kaže koje Geminijeve mogućnosti rade na samom uređaju, a koje u oblaku.

Googleprovjereno

Alatisrednji signal

Biblioteka tokenizers u novoj verziji pretvara tekst u tokene tri do trideset puta brže

Hugging Face je 21. septembra 2026. objavio kandidata za izdanje verzije 1 biblioteke tokenizers, zajedno s mjerenjima. Na deset porodica modela koje novi put kodiranja pokriva, biblioteka na jednoj niti procesora Apple M4 Max radi 3 do 30 puta brže nego verzija 0.23, a na osam radnih niti dostiže 76 odsto linearnog ubrzanja. Izlaz se pri tome ne mijenja: isti tekst daje iste identifikatore tokena, kroz iste pozive. Sve brojke su izmjerene nad paketom za Rust, dok Python omotač, kroz koji do biblioteke dolazi najveći dio ekosistema, dodaje trošak po pozivu koji u mjerenja nije uračunat.

Hugging Faceprovjereno

Mašine i lokalni modelijak signal

Apple za Mac Studio navodi 4,3 puta brži rad s modelima, a konfiguracija sa 512 gigabajta stiže u oktobru

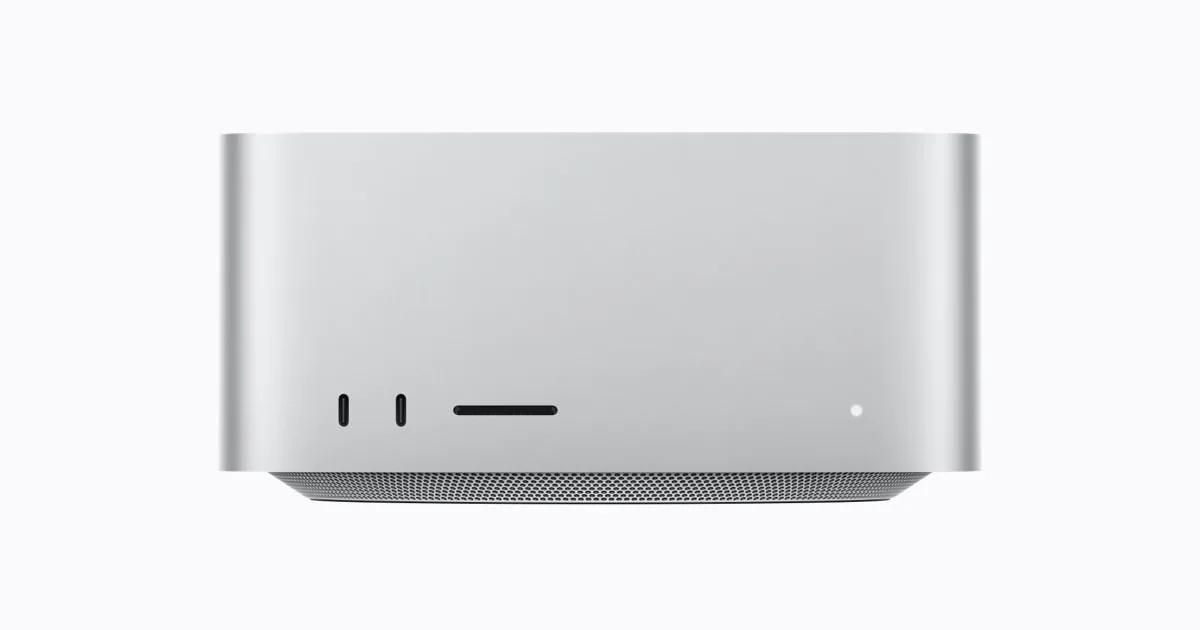
Mac Studio s čipovima M5 Max i novim M5 Ultra stiže u prodavnice 22. septembra 2026. Apple njegov rad s modelima vještačke inteligencije procjenjuje na do 4,3 puta brži nego kod prethodne generacije, mjereno u julu 2026. na mašini s čipom M3 Ultra. Konfiguracija od koje zavisi koliki lokalni model može da stane, 512 gigabajta objedinjene memorije uz do 1,2 terabajta u sekundi, navedena je u fusnoti: stiže krajem oktobra. Novi Siri AI izlazi kao beta izdanje, na početku samo na engleskom, i u Evropskoj uniji neće biti dostupan na iOS-u, iPadOS-u ni watchOS-u.

Appleprovjereno

Mašine i lokalni modelijak signal

NVIDIA je objavila besplatan alat koji lokalno izvođenje modela raspoređuje na slobodne računare u kući

Personal AI Router je objavljen 3. septembra 2026. na sajmu IFA. Alat je besplatan, otvorenog koda, i radi na sistemima Windows, macOS i Linux: pronalazi saglasne računare na lokalnoj mreži i svaki nezavisan zahtjev za izvođenje šalje onom koji ima slobodan kapacitet, pa uporedni podzadaci agenta prestaju da čekaju u redu pred istom grafičkom karticom. Sarađuje s alatima Ollama i LM Studio, a podržava GeForce RTX 20 Series i novije, radne stanice s karticama RTX PRO, DGX Spark i Apple silicijum M4. Memoriju, međutim, ne udružuje, pa model koji ne staje na jedan računar ni dalje ne staje.

NVIDIAprovjereno

Mašine i lokalni modelijak signal

Hugging Face objavio je 207 WebGPU kernela i alat koji ih preuzima s Huba

Paket @huggingface/kernels preuzima jednu operaciju grafičkog procesora s Huba i pokreće je u pregledaču koji podržava WebGPU. Svih 207 kernela objavljeno je pod licencom Apache-2.0, a u istom repozitorijumu nalaze se i opis interfejsa, testovi tačnosti i mjerni slučajevi. Hugging Face ih je uporedio sa ONNX Runtime Web 1.30.0 na grafičkom procesoru Apple M4 i navodi geometrijsku sredinu ubrzanja od 2,57 puta na 809 uporedivih slučajeva. Mjereno je samo vrijeme rada na grafičkom procesoru, i to za pojedinačne operacije, a ne za cijele modele.

Hugging Faceprovjereno

Mašine i lokalni modelisrednji signal

llama.cpp je dva dana radio na dugom kontekstu, a dobitak je pao na tri različita backenda

Između 29. i 31. avgusta 2026. llama.cpp je isporučio niz izmjena koje gađaju isto mjesto: dio zaključivanja koji postaje sporiji kako kontekst raste. Vulkan, CUDA i putanje za Metal i OpenCL dobili su svaka svoju popravku, uz brojke koje su autori objavili. Uz njih su zatvorena i tri rušenja. Ništa od toga ne traži zastavicu — stiže sa sljedećim izdanjem.

llama.cppprovjereno

Mašine i lokalni modelijak signal

Memorija određuje šta možeš da vrtiš lokalno, a cijena po tokenu da li ti se to isplati

Lokalni model ima jedan tvrd uslov prije nego što se uopšte otvori pitanje brzine, kvaliteta ili licence: težine moraju da stanu u memoriju. Izbor mašine se time svodi na računicu na papiru, a Appleovi stoni računari od 25. avgusta daju tri cijene naspram kojih se ona vodi — 899 dolara za granicu od 32 GB, 2.499 za 128 GB i 5.499 za 512 GB. Ovaj vodič pokazuje šta gdje staje, čime se pokreće, za šta je koja veličina dobra i poslije koliko tokena sopstvena mašina postaje jeftinija od plaćanja po tokenu.

Apple, OpenRouter, DeepSeekprovjereno

Modelisrednji signal

Qwen je otvorio model od 125 milijardi parametara sa šest milijardi aktivnih, a hardver bira kvantizovana datoteka

Qwen3.8-Flash-Next je multimodalni model otvorenih težina po principu mješavine eksperata i rani pregled arhitekture na kojoj će stajati Qwen4. Zanimljiv je par brojki: 125 milijardi parametara naspram 6 milijardi aktiviranih po tokenu. Prva određuje hoće li model stati na raspoloživu mašinu, a druga koliko brzo odgovara. Simon Willison ga pokreće na računaru DGX Spark iz kvantizovanih datoteka od 72,5 i 78,9 gigabajta, što je zahtjev za hardver u najupotrebljivijem obliku.

Qwenprovjereno

Modelisrednji signal

IBM je izdao model za rasuđivanje u tri veličine, a najmanji staje na laptop

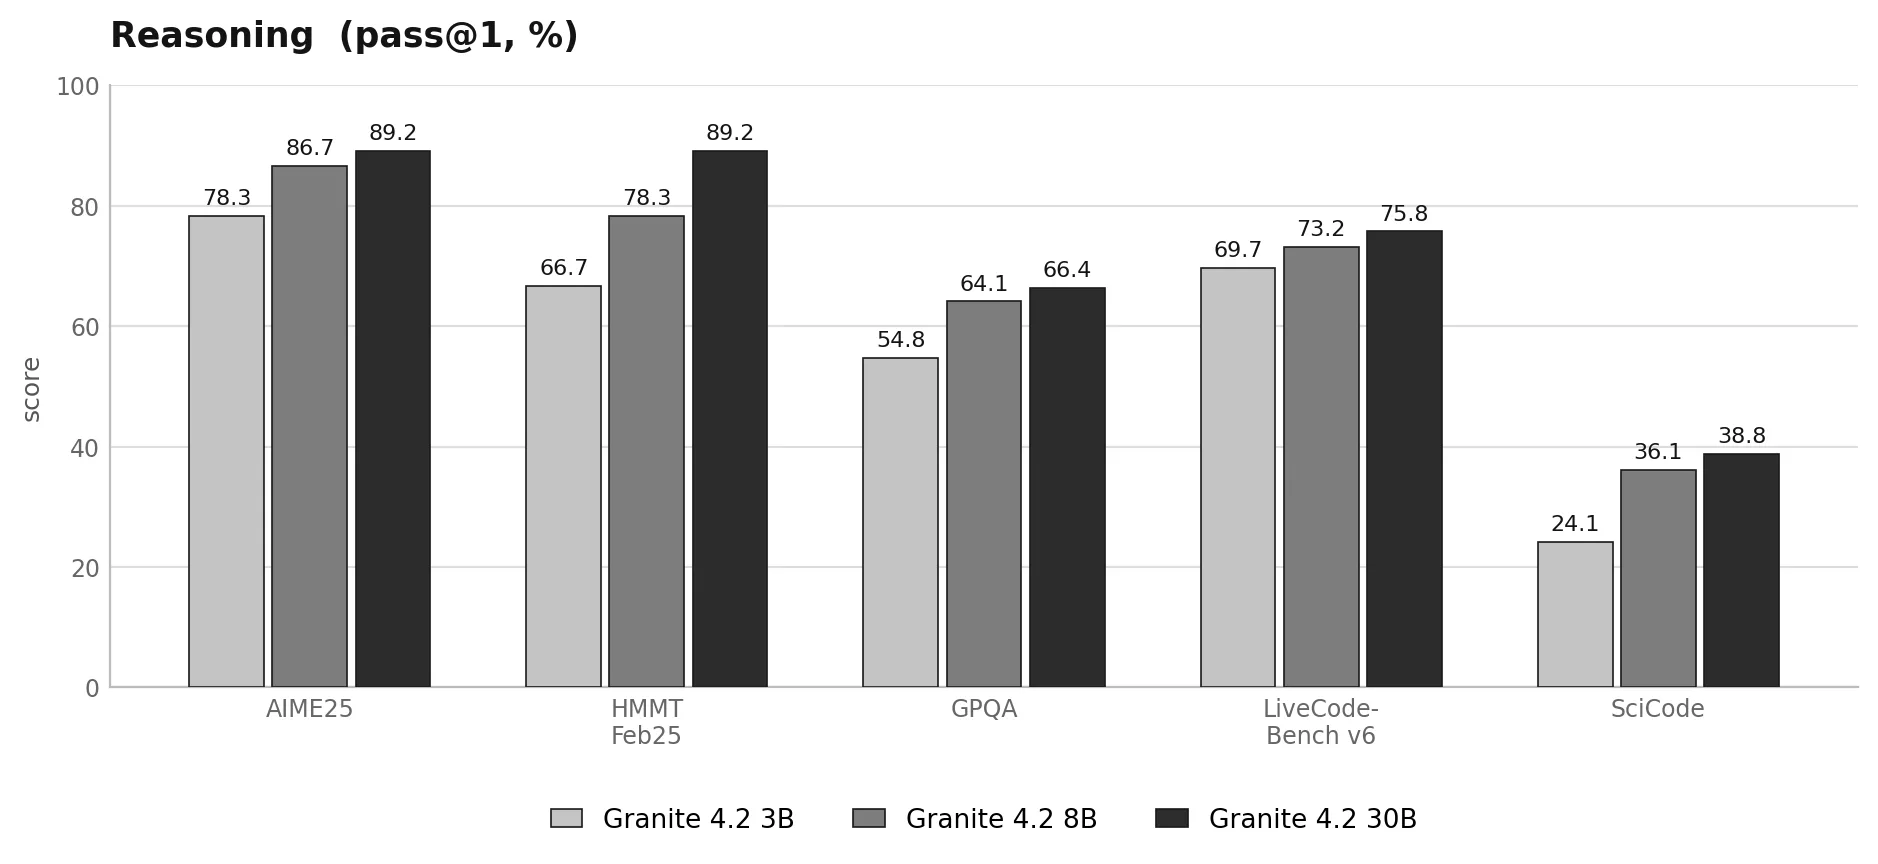
Granite 4.2 dolazi u tri veličine, od tri, osam i trideset milijardi parametara, pod licencom Apache 2.0, a uz težine su odmah objavljena i izdanja u GGUF-u i na četiri bita. Zanimljiv dio nije tabela mjerenja — nego to što su licenca i formati riješeni prvog dana.

IBMprovjereno

Mašine i lokalni modelijak signal

Apple je naplatio memoriju, a memorija je ono što lokalni model zaista košta

Novi Mac Studio ide do 512 GB objedinjene memorije i počinje od 5.499 dolara, ali konfiguracija s 512 GB stiže tek krajem oktobra; novi Mac mini staje na 32 GB i počinje od 899. Za svakoga ko modele vrti na sopstvenoj mašini, taj raspon je cijela ponuda — i Apple je sada tako i prodaje.

Appleprovjereno