Biblioteka tokenizers u novoj verziji pretvara tekst u tokene tri do trideset puta brže
Hugging Face je 21. septembra 2026. objavio kandidata za izdanje verzije 1 biblioteke tokenizers, zajedno s mjerenjima. Na deset porodica modela koje novi put kodiranja pokriva, biblioteka na jednoj niti procesora Apple M4 Max radi 3 do 30 puta brže nego verzija 0.23, a na osam radnih niti dostiže 76 odsto linearnog ubrzanja. Izlaz se pri tome ne mijenja: isti tekst daje iste identifikatore tokena, kroz iste pozive. Sve brojke su izmjerene nad paketom za Rust, dok Python omotač, kroz koji do biblioteke dolazi najveći dio ekosistema, dodaje trošak po pozivu koji u mjerenja nije uračunat.
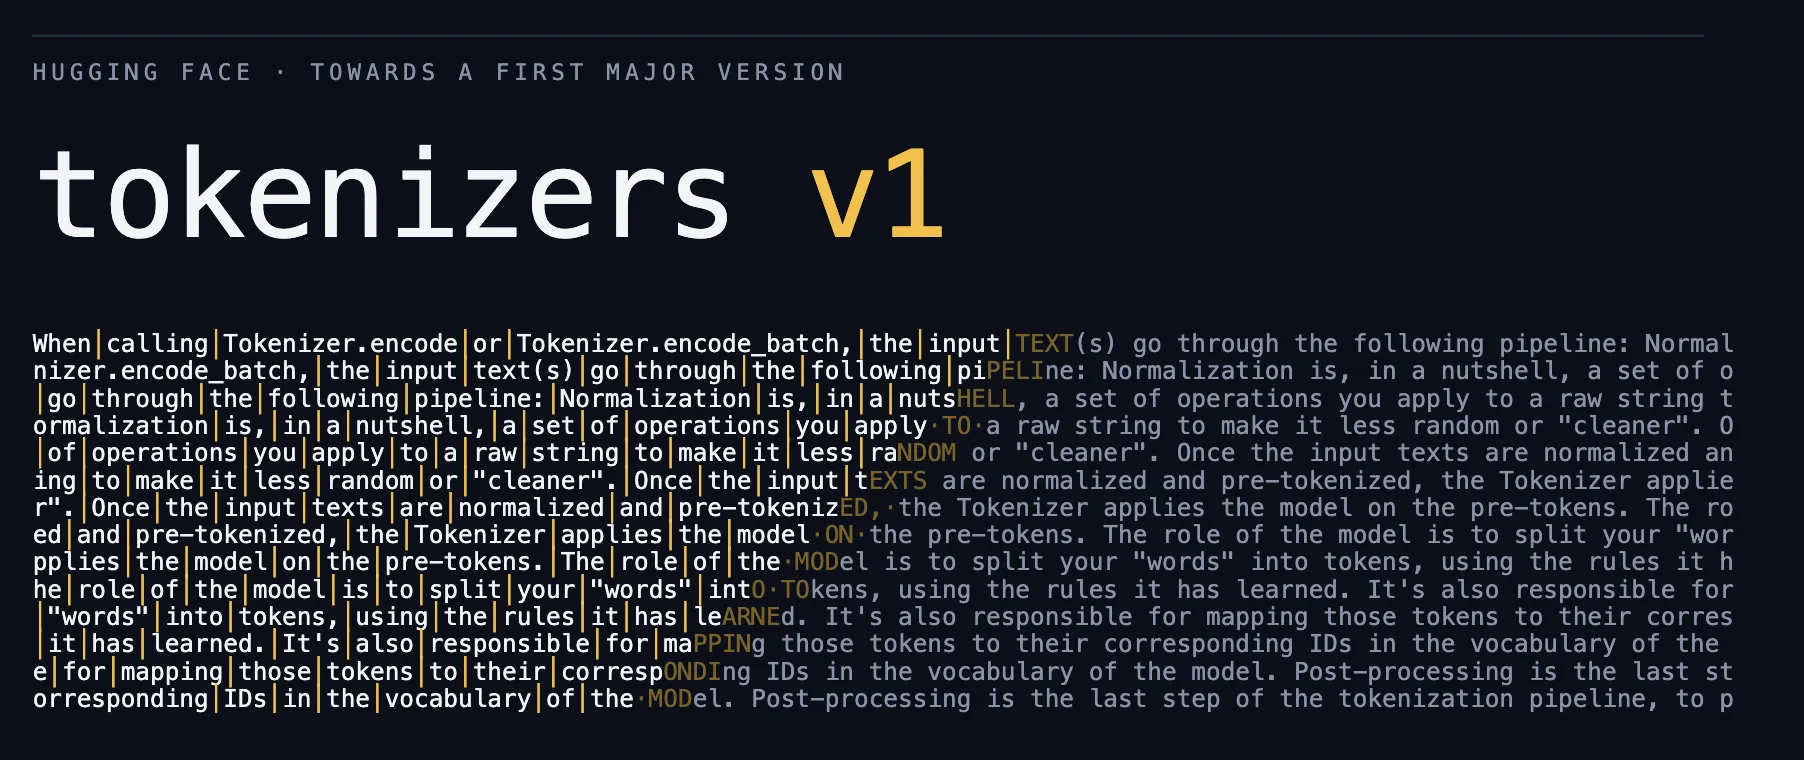
Izvor
tokenizers v1: encode, decode and scaling, measuredHugging Face Blog · Original objavljen 21. septembra 2026.
Tokenizator je rijetko dio lanca obrade koji iko mjeri. Hugging Face je ciklus verzije 1 posvetio upravo tom dijelu i 21. septembra 2026. objavio rezultate. Kandidat za izdanje pretvara tekst u tokene 3 do 30 puta brže od verzije 0.23, na deset porodica modela koje novi put kodiranja pokriva, mjereno na jednoj niti procesora Apple M4 Max. Ono što izlazi ostaje isto: isti tekst i dalje daje iste identifikatore tokena.
Šta je izmjereno
Glavna brojka je raspon zato što dobitak zavisi od samog tokenizatora. Donja granica, oko tri puta, izmjerena je na modelu t5-base, a gornja, oko trideset puta, na modelu gpt2. Osam od deset mjerenih porodica koristi kodiranje parova bajtova, a preostale dvije koriste WordPiece i Unigram. Na osam radnih niti kodiranje dostiže 76 odsto linearnog ubrzanja, a to je slučaj koji je važan kad jedan tokenizator opslužuje veliki broj istovremenih zahtjeva.
Kod tokenizatora male razlike u postavci mjerenja daju velike razlike u rezultatu, pa metod ide uz brojke. Svi pokretači prolaze kroz istu petlju mjerenja, učitavanje rječnika se mjeri odvojeno i nikad ne ulazi u vrijeme kodiranja, a izlazni identifikatori se otiskom provjeravaju u odnosu na polaznu vrijednost. Radne niti su vezane za osam različitih fizičkih jezgara, a ne za dvije niti istog jezgra, i svako ponavljanje počinje u novom procesu. Glavne brojke su dobijene na nizu različitih dokumenata, a ne na jednom dokumentu koji se kodira iznova, jer taj drugi posao mjeri potpuno popunjenu privremenu memoriju.
- Novi put kodiranja pokriva deset porodica modela, a osam njih koristi kodiranje parova bajtova.
- Poređenje je s verzijom 0.23, na jednoj niti procesora Apple M4 Max.
- Kodiranje na više niti dostiže 76 odsto linearnog ubrzanja na osam fizičkih jezgara.
- Identifikatori tokena, programski interfejs, rječnik i rangovi spajanja ostaju nepromijenjeni.
Odakle dolazi brzina
Najveći dio dobitka dolazi od četiri izmjene, i svaka uklanja posao na drugom mjestu. Podjela teksta više ne pokreće opšti mehanizam regularnih izraza. Obrazac po kojem se tekst dijeli isporučuje se uz model i ne mijenja se tokom rada, pa ga verzija 1 zamjenjuje ručno napisanom funkcijom pod imenom bitcannon. Ta funkcija ulazne bajtove čita kao uporedne nizove bitova i uz SIMD instrukcije odlučuje o 64 bajta po jednoj operaciji nad registrom. Privremena memorija vezana za nit čuva gotove identifikatore već viđenih pre-tokena, pa se ponovljena riječ spaja samo jednom. Petlja spajanja radni skup čuva u baferu koji pripada pozivaocu i simbole povezuje po položaju, a model se poziva jednom po grupi pre-tokena umjesto jednom po svakom pre-tokenu.
Raspon u glavnoj brojci slijedi iz prve od tih izmjena. Funkcija bitcannon prepoznaje nekoliko obrazaca podjele, a objava navodi GPT-2, cl100k, o200k, Tekken i DeepSeek. Tokenizator čiji obrazac nije među njima ostaje na putu s regularnim izrazom i ne dobija ništa od ubrzanja. Jedan paket je pri tome podijeljen na radni prostor, pa aplikacija povezuje samo tk-encode, dok serijalizacija, pretvaranje i treniranje ostaju izvan izgradnje.
Ko ovo već može da koristi
Kandidat za izdanje objavljen je kao pretpremijerni paket, a kod koji kodira tekst ne mijenja se da bi ga koristio. Projekat to kaže bez uvijanja: kodiranje je nepromijenjeno, isti poziv i isti identifikatori. Treniranje se uključuje mogućnošću koja je podrazumijevano aktivna i povlači zavisnost napisanu u jeziku C++, pa izgradnja namijenjena samo kodiranju tu mogućnost isključuje.
Najveći dio ekosistema do ove biblioteke dolazi kroz Python, a to nije put na kojem su brojke mjerene. Omotač pokriva isti kod u Rustu, ali dodaje trošak po pozivu koji nijedno od ovih mjerenja ne obuhvata, a jednostavniji omotač je naveden kao posao za verziju 1.0.0, ne kao završen posao. Iz toga se može zaključiti da praktičan dobitak stiže u dva koraka: odmah za one koji zovu iz Rusta i za servise koji paket ugrađuju, kasnije za biblioteku transformers, koju objava navodi kao sljedeći cilj. Na istom spisku za verziju 1.0.0 najavljeni su i omotači za C i C++ namijenjeni samo izvođenju, za ExecuTorch i llama.cpp.
„Kodiranje je nepromijenjeno: isti poziv, isti identifikatori.“
Povezano
Python 3.15 uvodi UTF-8 kao podrazumijevano kodiranje i odloženo učitavanje modula
Python 3.15.0 objavljen je 9. oktobra 2026. Datoteke otvorene bez zadatog kodiranja sada se na svakom sistemu čitaju i pišu kao UTF-8, a nova naredba lazy import odlaže učitavanje modula do trenutka kad zatreba. Izdanje donosi i tip frozendict i profiler koji radi uzorkovanjem.
Python Software Foundationprovjereno
Tim Denoa prelazi u Cloudflare, a okruženje Deno dobija još godinu dana ispravki
Ryan Dahl je 9. oktobra 2026. objavio da cijeli tim Denoa prelazi u Cloudflare. Izvršno okruženje Deno dobijaće mjesečne ispravke još godinu dana, a potom se razvoj završava. Servis Deno Deploy gasi se za šest mjeseci, dok registar JSR nastavlja da radi.
Denoprovjereno
Anthropic održavaocima otvorenog koda besplatno šalje izvještaje o ranjivostima koje nije pregledao čovjek
Anthropic je 8. oktobra 2026. pokrenuo OSS Scanner, besplatnu uslugu skeniranja za projekte otvorenog koda koji se sami prijave. Skeniranje rade najjači modeli kompanije, među kojima je Claude Mythos. Svaki izvještaj sadrži postupak za reprodukciju greške, objašnjenje i predlog ispravke kad postoji, ali ga prije slanja ne provjerava nijedan čovjek. Anthropic navodi da očekuje da više od 90 odsto nalaza bude tačno.
Anthropicprovjereno