Ai2 je objavio metod koji pokazuje šta pojedinačna pitanja u mjerilima zapravo mjere
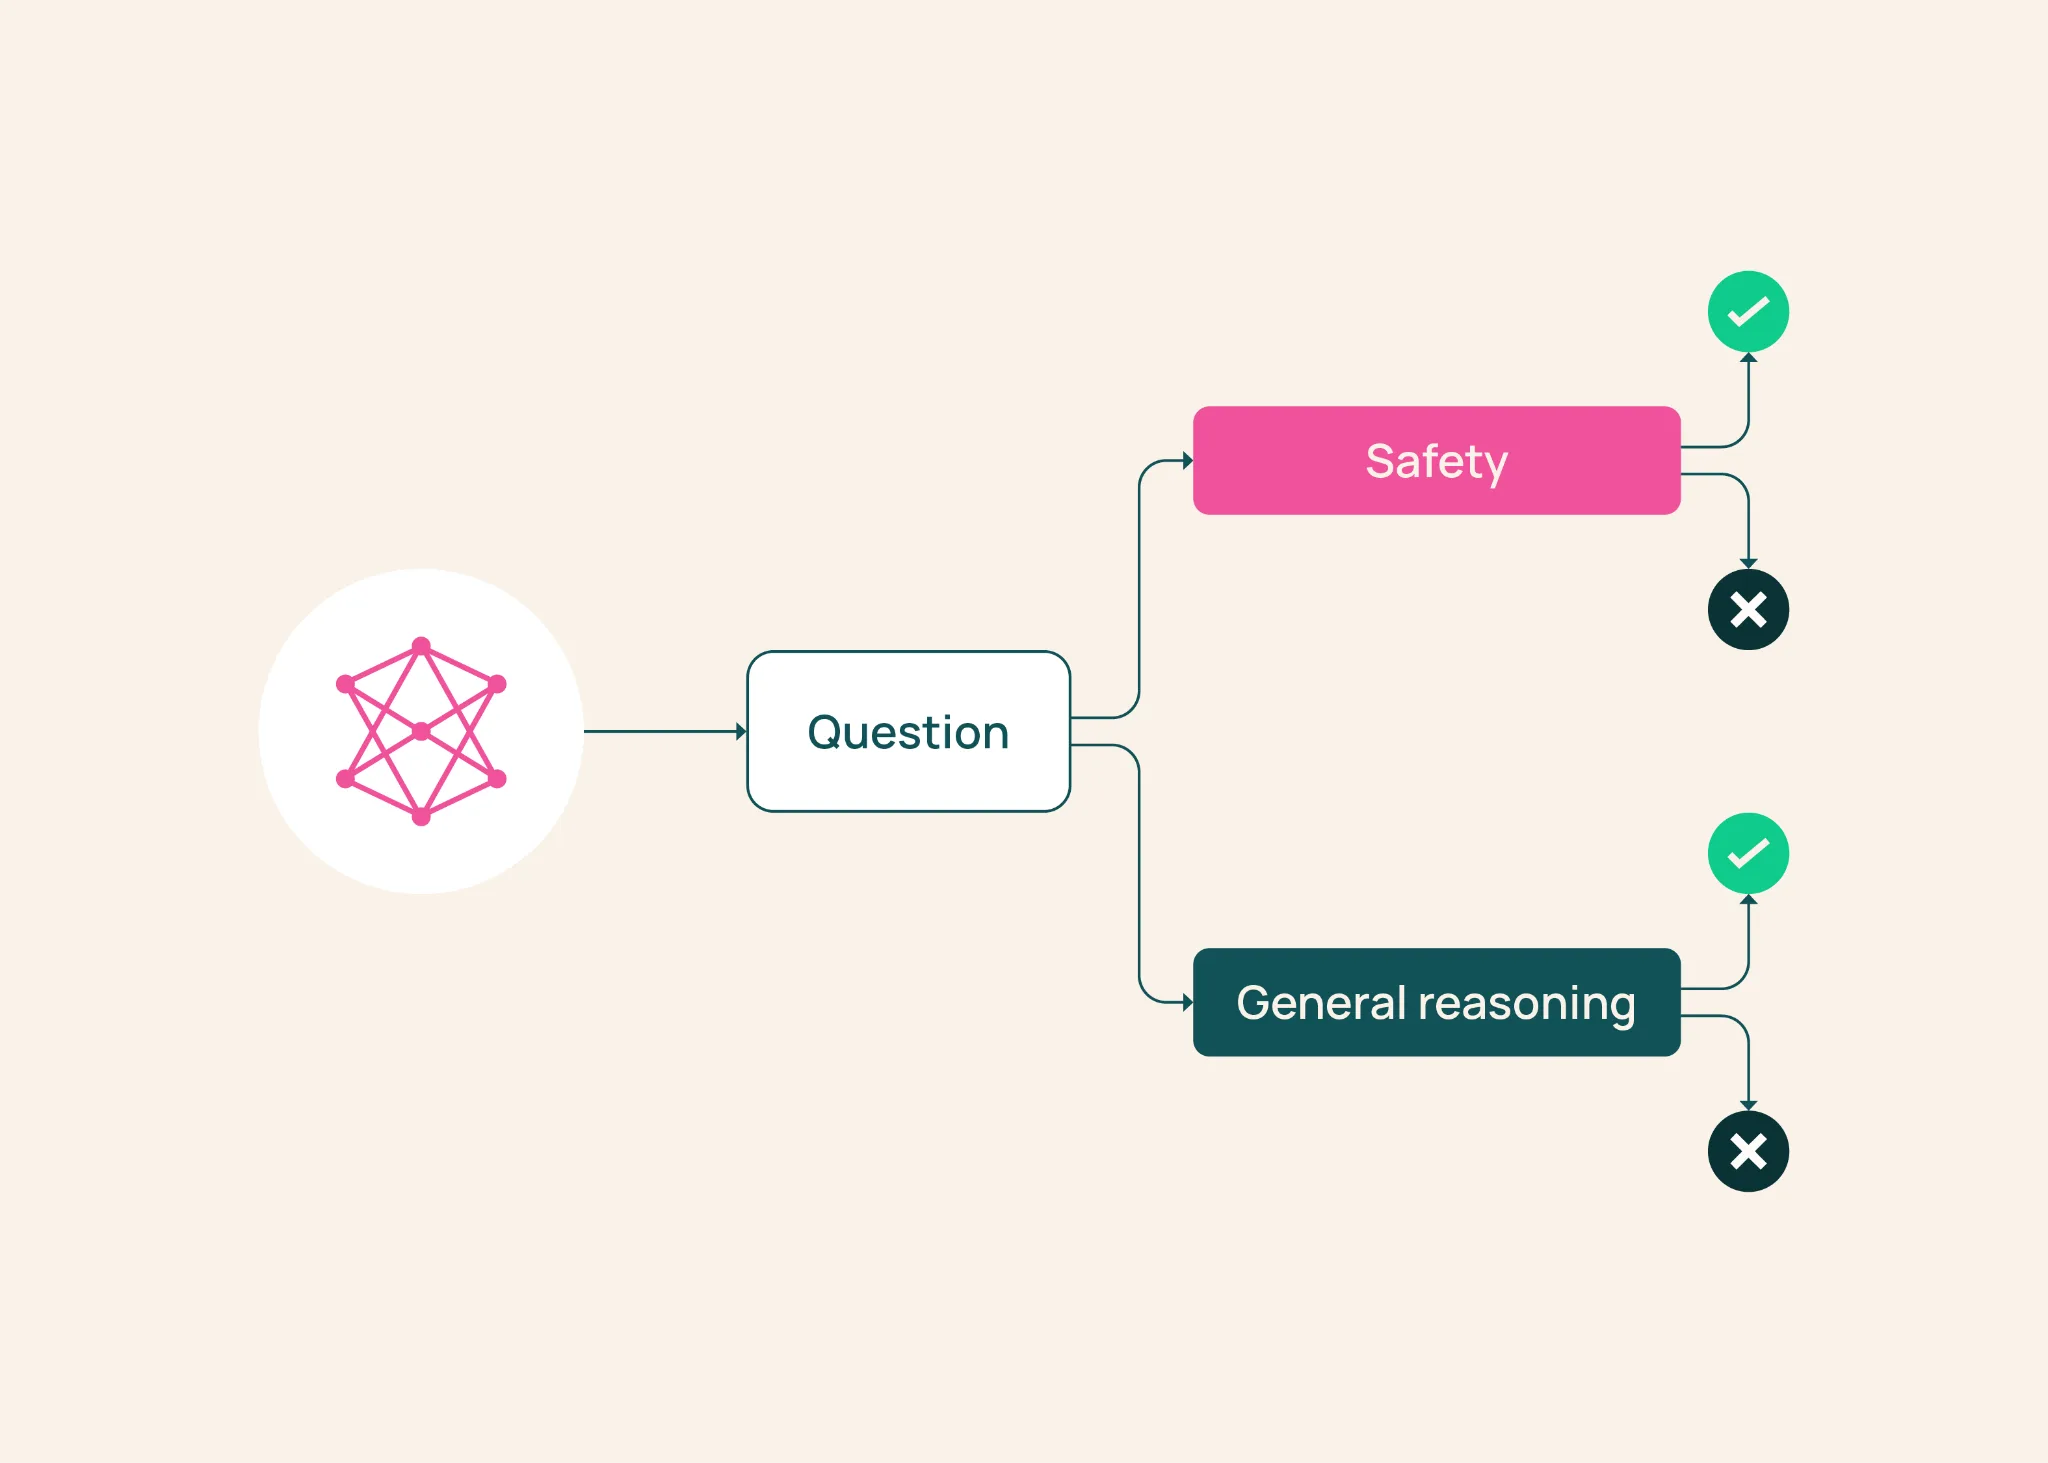
BenchMIRT uzima teoriju odgovora na stavku iz psihometrije i primjenjuje je na mjerilo pitanje po pitanje, umjesto da vjeruje prosjeku. Obučen na 100 modela, 16 mjerila i više od 34.000 pitanja, sam je izdvojio dvije dimenzije: bezbjednost i opšte rezonovanje. Nekoliko mjerila je završilo na dimenziji na koju ih niko nije svrstao. Zadržavanje 10 odsto pitanja dalo je gotovo isti poredak kao i cio skup.
Izvor
BenchMIRT: What are LLM benchmarks actually measuring?Hugging Face Blog · Original objavljen 1. septembra 2026.
Ai2 je 1. septembra 2026. objavio BenchMIRT, metod za provjeru mjerila za jezičke modele na nivou pojedinačnog pitanja, a ne konačne ocjene. Polazna pretpostavka je da mjerilo namjerava da izmjeri jednu sposobnost, dok pitanja u njemu često zavise od nekoliko njih. Kad se ti signali usrednje u jedan broj, taj broj prestaje da govori ono što mu ime obećava.
Kako metod radi
Teorija odgovora na stavku dolazi iz psihometrije i počinje od jednostavnog zapažanja: ne govori svako pitanje jednako mnogo o onome ko rješava test. Neka su teža, a neka bolje razdvajaju jače od slabijih. Jednodimenzionalna varijanta je i ranije primjenjivana na pojedinačna mjerila. BenchMIRT koristi višedimenzionalnu, pa umije da razdvoji nekoliko sposobnosti koje ulaze u isto pitanje.
Procjenjuje dvije stvari odjednom. Za model procjenjuje snagu na sposobnostima koje se pojavljuju u izabranim mjerilima. Za pitanje procjenjuje težinu i to koliko dobro razdvaja jače modele od slabijih. Ai2 ga je obučio na rezultatima 100 jezičkih modela na 16 mjerila i više od 34.000 pitanja. Šest mjerila mjeri rezonovanje, među njima MMLU-Pro, GPQA, MATH i BBH, a deset dolazi iz bezbjednosnog skupa projekta Olmo 3. Metodu niko nije rekao koje mjerilo šta mjeri, a on je svejedno izdvojio dvije preovlađujuće dimenzije: bezbjednost i opšte rezonovanje.
Šta je našao u postojećim mjerilima
Za veći dio skupa se namjera mjerila potvrdila. Tri slučaja nisu, a svaki od njih je vrsta greške koja neprimjetno iskrivi poređenje dva modela.
- BBQ ispituje društvene predrasude i obično se svrstava među bezbjednosna mjerila, a mnogo se jače poklopilo s opštim rezonovanjem. Slaba ocjena zato dijelom može značiti i teškoću u razumijevanju pitanja, a ne samo ponašanje modela prema predrasudama.
- WMDP ispituje opasno dvonamjensko znanje i takođe je pratilo rezonovanje umjesto bezbjednosti, i to u obrnutom smjeru. Jače rezonovanje je išlo uz slabiju ocjenu, jer se odbijanje da se to znanje pruži računa kao tačan odgovor.
- HarmBench u sebi miješa signale, pa su njegovi obični i kontekstualni štetni zahtjevi legli na bezbjednost, dok su pitanja o autorskim pravima legla na opšte rezonovanje.
Manje pitanja, gotovo ista slika
Procjene na nivou pitanja omogućavaju da se pitanja poredaju po tome koliko dobro razdvajaju modele. Ai2 je to uradio na istih 16 mjerila i navodi da je zadržavanje samo 10 odsto pitanja uglavnom davalo gotovo istu sliku o tome koji su modeli jači u posmatranoj sposobnosti. Zadržavanje polovine pitanja se često još bliže poklapalo s cijelim skupom.
Metod umije i da predvidi kako bi model prošao na pitanju na kojem nikad nije ocijenjen. Pogodio je u 79 odsto slučajeva, prema 70 odsto koliko daje jednostavnija pretpostavka da model na svakom pitanju prolazi otprilike kao i na mjerilu u cjelini. Ta razlika je praktična dobit, jer za istu ocjenu modela treba manje pokretanja provjere.
Ograničenja koja autori sami navode
Svi modeli na kojima je BenchMIRT obučen i provjeren objavljeni su zaključno s martom 2025, pa ovaj rad ne govori kako se metod ponaša na današnjim modelima. Dimenzije koje pronalazi zavise i od skupa mjerila koji mu se da, a drugačiji izbor bi mogao da izdvoji druge sposobnosti. Ai2 dodaje i da za puko rangiranje modela na nasumično izdvojenim pitanjima obični prosjek mjerila radi nešto bolje.
Autori imenuju i očiglednu opasnost. Iste procjene koje pronalaze najinformativnija bezbjednosna pitanja mogu se upotrijebiti i da se ta pitanja uklone, pa bi ostala slabija provjera kroz koju bi nebezbjedan model prošao. Oni smatraju da je veća prozirnost vrijedna tog rizika i podsjećaju da se slično skraćivanje već može izvesti postojećim alatima, ali rizik navode kao stvaran, a ne kao teorijski.
„jedna ocjena mjerila može da sadrži nekoliko različitih signala“
Povezano
Reflection je objavio otvoreni model Beam sa 501 milijardom parametara pod licencom Apache 2.0
Američka laboratorija Reflection objavila je 16. oktobra 2026. na Hugging Faceu težine svog prvog modela, Beam. Model ima 501 milijardu parametara, od kojih su po tokenu aktivne oko 23 milijarde, i kontekst od 1 milion tokena. Namijenjen je programiranju i radu agenata, a licenca dozvoljava komercijalnu upotrebu i dodatno obučavanje.
Reflectionprovjereno
Meta je objavila težine modela Muse Spark Open sa 816 milijardi parametara
Muse Spark Open je najveći Metin model s otvorenim težinama do sada, objavljen 15. oktobra 2026. Prima tekst, slike, zvuk i video, a od 816 milijardi parametara na pojedinačnom tokenu radi oko 42 milijarde. Licenca je za većinu namjena besplatna, a provajderi koji ga poslužuju naplaćuju 1,25 dolara po milionu ulaznih tokena.
Metaprovjereno
Gemini 4 Argon je dostupan plaćenim korisnicima API-ja i pretplatnicima, uz uvodnu cijenu do 30. novembra
Google je 13. oktobra 2026. počeo globalno uvođenje modela Gemini 4 Argon, dvije sedmice pošto ga je dao samo provjerenim timovima za sajber bezbjednost. Programeri ga pozivaju kroz plaćeni nivo Gemini API-ja, a pretplatnici planova Google AI Pro i Ultra dobijaju ga u aplikaciji Gemini. Uvodna cijena od 2 dolara po milionu ulaznih i 10 dolara po milionu izlaznih tokena važi do 30. novembra 2026. API uz to drugačije vraća duge odgovore i drugačije kešira promptove.
Googleprovjereno